
2400万人围观,前OpenAI研究员做了个「闭嘴」模型
编辑|山辉
你敢信, 曾经全力推动 AI 学 着说话的人,现在做出了一个「闭嘴」的模型。
前 OpenAI 研究员 Diogo Almeida 终于结束了两年的隐身状态,正式发布新模型 Jev。
 Almeida 是 2022 年 InstructGPT 论文的共同作者之一,也参与了 OpenAI 早期 RLHF 与 GPT-4 的相关工作。可以说,今天 ChatGPT 式「能听懂人话、会和人聊天」的模型训练路线,他是早期参与者之一。
但在离开 OpenAI 后,他开始怀疑这条路线。
「大模型现在非常擅长聊天,但聊天能力真的是软件自动化需要的核心能力吗?」
这个问题, Almeida 已经思考了四年。
现在,他给出了一个很直接的答案:也许 AI 根本不需要这么爱说话。
TypeSafe 推出的首款 System One Model Jev,直接放弃了自由文本生成。
官方给出的数字相当夸张, 速度提升 20-200 倍,成本最高可降至原来的 1/400,输出 Token 甚至免费。
一个「拒绝说话」的 AI
假设现在有一封用户邮件。你想知道三个问题:它是不是投诉?问题紧不紧急?应该转给哪个部门?
普通大模型会先阅读邮件,再一个 Token 一个 Token 地生成回答:「根据用户的描述,我认为这封邮件属于……」
程序随后还得从这段文字里重新找到真正需要的信息,把它解析成字段,再决定下一步做什么。
而 Jev 直接省掉了中间这段话。
你提前规定好程序需要哪些结果,它读取输入后, 直接给出类型确定的结构化判断,以及每个判断对应的概率和置信度。
TypeSafe 对它的概括是: 「非结构化状态进去,带类型的概率决策出来。(Unstructured state in, typed probabilistic decisions out.)」
更关键的是,这些结果可以并行产生。
传统 LLM 采用自回归生成方式,每一个 Token 都依赖前面的 Token;Jev 的目标里没有一整段文章、代码或者解释,自然也不需要慢慢「写」完答案。
用并行计算替换顺序计算的方式,官方文档:https://typesafe.ai/blog/introducing-system-one-models-and-jev
TypeSafe 称, Jev 的端到端响应时间可以做到约 70-500 毫秒,输入价格为每百万 Token 0.042 美元,输出目前免费。
在公司自己的 workflow eval 中,最高测出了 193.6 倍 的速度优势和 444.6 倍的成本优势。
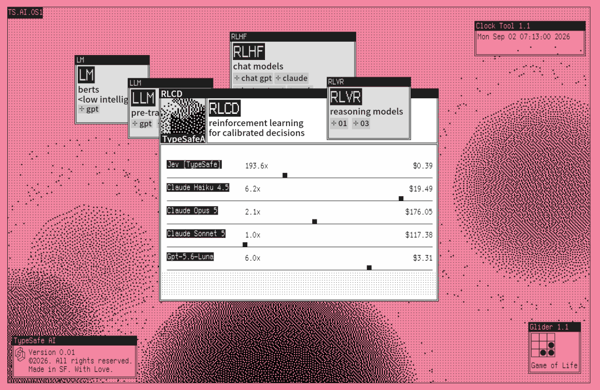 图源 TypeSafe 官网:https://typesafe.ai/ 当然,这组数字需要加一个很大的限定条件。TypeSafe 自己也承认,这可能已经接近现实工作流收益的高位,而且测试 workflow 来自内部团队,无法完全排除设计偏差。
好在外部实测的结果看上去也相当不错。
Every 的评测负责人 Mike Taylor 拿 Jev 检查了 37 篇文档,一口气完成 777 次独立判断,总耗时不到 0.7 秒。
 链接:https://every.to/also-true-for-humans/mini-vibe-check-typesafe-s-jev-judged-everything-i-ve-written-in-0-7-second
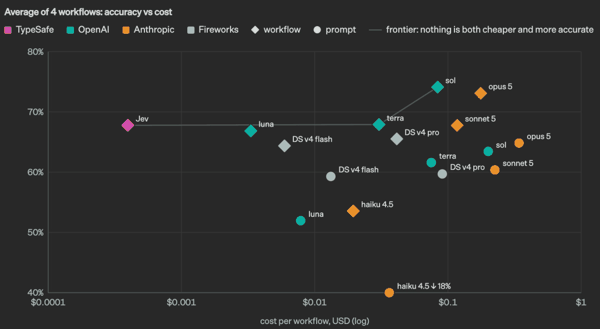
在其中一个写作质量判断任务中, Jev 用时约 0.35 秒,Fable 5.1 则需要 8.83 秒;前者约快 25 倍,成本约低 580 倍。
至少在这类高度结构化的「判断题」上,它确实展现出了惊人的效率曲线。
 做出 RLHF 的人,开始反思 RLHF
更有意思的是 Jev 背后的训练方法。TypeSafe 给它起了一个新名字: RLCD,Reinforcement Learning for Calibrated Decisions,面向校准决策的强化学习 。
这个名字本身就是在回应 RLHF。
RLHF 的核心目标很好理解:让人类评价多个答案,然后训练模型生成更受人喜欢的结果。
这条路线让原本只会预测下一个 Token 的语言模型,逐渐学会遵循指令或者解释问题,最终成为今天我们熟悉的聊天助手。InstructGPT 当年采用的正是这套思路。
Almeida 现在认为,当模型要进入软件系统时,「人的偏好」未必是最重要的训练目标。
一个聊天助手面对不确定的问题,可以写几段听起来很完整的回答。但如果它处在一个每天自动执行数百万次的工作流里,真正重要的问题可能只有两个:答案是什么?这个答案到底有多确定?
RLCD 因此把「 校 准 」放到了核心位置。
简单来说,如果一个模型长期对一类判断给出 90% 的置信度,那么这些判断最好真的有大约 90% 是正确的。这样,软件才能围绕概率继续写逻辑:
95% 以上,直接执行;
70%,交给更强的模型继续判断;
40%,送给人类。
AI 由此更像一个可以插进程序里的「模糊 if 语句」。
这也是 TypeSafe 所说的「composable intelligence」:智能不必每次都以一整段自然语言出现,它可以成为软件内部随时调用的一项能力。
AI 不说话,也就不会有幻觉了?
TypeSafe 甚至有一个更激进的宣传: Je v「 不会幻觉」。
Hold on hold on,此「幻觉」非彼「幻觉」。
我们通常说大模型产生幻觉,想到的是它一本正经地编出一个不存在的人名、论文或者事实。
但 TypeSafe 这里强调的其实是另一类问题: 模型生成了程序根本没有定义、也无法处理的输出。
这还是前面所说,着眼于「程序自动化」而非「人类阅读」。
比如让 AI 判断一封邮件属于「投诉」「退款」还是「咨询」。普通大模型即使被要求按照固定格式回答,仍然是在生成字符串,它理论上可以突然回答一个选项中并不存在的「严重投诉」,或者额外生成一大段解释。
对人来说,这可能只是增加了阅读量和理解难度;但进入自动化系统后,下游程序根本不知道该怎么处理这个凭空出现的新类别。
Jev 从源头上砍掉了这种可能。
它不自由生成字符串,所有可能的输出及其类型都提前定义好了。如果程序只允许「投诉」「退款」「咨询」三个答案,它就只能从这三个答案中选择,不会临时创造第四个。
这就是 TypeSafe 所说的 type safety。
官方甚至明确注明, Jev 的「0% hallucination」并不是跑了大量测试后统计得到的经验数据。因为 schema matching 本身就是被保证的,所以他们直接把这一数字记为了 0%! (也是蛮「幽默」的。)
玩笑归玩笑,如果把「幻觉」换回我们更熟悉的定义,Jev 和这个问题也并非毫无关系。
大模型为什么会一本正经地胡说?
一个很重要的原因是,语言模型最初学习的任务就是预测下一个词。训练数据里的每句话,并不会额外附上一张「真 / 假」标签。于是对于大量低频、模糊或者模型本身并不知道的信息,它仍然可以根据语言规律生成一个「很像正确答案」的答案。
更麻烦的是, 后续的训练和评测往往还会奖励「猜一个答案」 。
OpenAI 去年专门研究过这个问题:如果一道题答错和回答「不知道」都拿不到分,那么猜一个具体答案至少还有蒙对的可能。久而久之,模型更容易学会在不确定时继续回答,而不是把自己的不确定性暴露出来。