
FCS首发|登顶全球TOP 500:“灵晟”超智融合算力架构的研发与应用全解析
FCS 首发 | 登顶全球TOP500:“灵晟”超智融合算力架构的研发与应用全解析
论文标题: LineShine: Online Acceleration for HPC-AI Converged Scientific Computing
期刊: Frontiers of Computer Science
作者:Yutong LU, Guangnan FENG, Haohuan FU
发表时间:3 Sept 2026
DOI: 10.1007/s11704-026-61591-w
微信链接: 点击此处阅读微信文章
引言
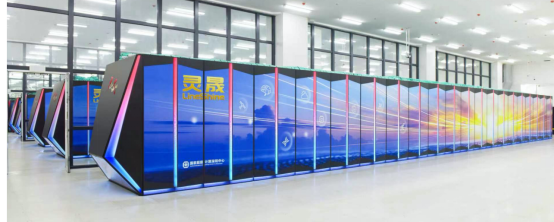
时隔九年,中国超算重返世界之巅的消息引发全球算力领域高度关注。部署于国家超级计算深圳中心的“灵晟”系统登顶全球 TOP500 榜单,成为全球首个突破2 EFlops大关的超算系统,同时拿下HPCG榜单第一,实现算力性能与运行能效的双重突破。
这一标志性成果的背后,是国家超级计算深圳中心、中山大学卢宇彤教授团队首创的Online Acceleration 超智融合全CPU架构。全面介绍“灵晟”研发与多领域应用实践的论文已被Frontiers of Computer Science(FCS)接收,JA(Just Accepted)版本已在线发表,欢迎阅鉴。
文章信息
标题: LineShine: Online Acceleration for HPC-AI Converged Scientific Computing
作者: Yutong Lu, Guangnan Feng, Haohuan Fu
网址:
https://journal.hep.com.cn/fcs/EN/10.1007/s11704-026-61591-w

引用格式: Yutong Lu, Guangnan Feng, Haohuan Fu. LineShine: Online Acceleration for HPC-AI Converged Scientific Computing. Front. Comput. Sci. DOI:10.1007/s11704-026-61591-w
内容精要
现代科学计算正日益呈现多种计算负载相互融合的特征。一个完整的科学计算应用工作流程往往是在数值模拟、AI推理或训练、稀疏与不规则计算、大规模通信以及数据密集型处理等不同阶段之间不断切换。传统异构CPU+加速器的离线加速超算系统对于许多计算任务虽具有较高性能,但其异构计算部件间的数据移动开销大、当数值模拟与AI计算之间需要频繁交互、数据传输和同步协调操作,以及相互独立的软件运行支撑环境,这些都会影响系统效率。
中山大学教授、国家超级计算深圳/广州中心主任、灵晟超级计算机总设计师卢宇彤带领团队,采用Online Acceleration的高效超智融合架构设计了“灵晟”,高效解决了上述问题,为世界超算系统研制提供了一条崭新的技术路径。
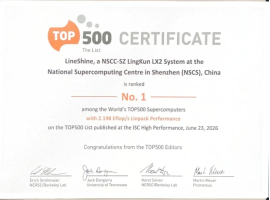
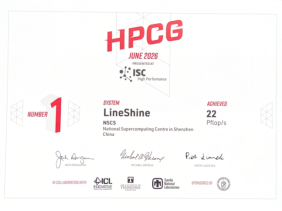
卢宇彤教授团队在德国汉堡举行的ISC26大会上
荣获的灵晟系统TOP500和HPCG排名第一的证书
灵晟系统设计
灵晟系统设计遵循应用驱动、平衡设计、全栈协同的设计原则,采用Online Acceleration全CPU架构,其核心是LX2处理器。LX2是一款采用Chiplet设计的304核众核CPU,每个CPU核心均集成了SME矩阵计算单元与SVE向量计算单元,并具备高性能片内高带宽内存结构。处理器原生支持多种精度计算,覆盖用于科学模拟的FP64和FP32,以及用于AI训练与推理的FP16、BF16和INT8,片上支持超智融合计算。由于标量、向量、矩阵、控制流、通信和I/O操作共享CPU执行环境、内存层次和软件栈,应用可以对这些操作进行细粒度组合,无需像CPU+GPU此类异构结构的系统反复跨越分离的CPU与加速器执行域。每颗LX2处理器在封装内集成32 GB HBM,并配备256 GB DDR5内存,以兼顾访存带宽和内存容量,可有效支撑数值模拟和AI计算的高带宽低延迟的多种访存需求;专用SDMA引擎负责在两级内存之间异步搬移数据。
灵晟整机由约90个计算机柜、22,680个计算节点和超过1300万个处理器核心组成。在系统层面,灵启互连通信系统采用双平面×四轨胖树拓扑,在支持十万节点级大规模扩展的同时提供网络冗余可靠性。封装内网卡可以直接访问HBM和DDR并执行远程直接内存访问,网络通讯最小延迟1.07us,整个网络的对分带宽超过3.5Pbps。设计实现层次化存储系统和对称分布式并行文件系统,支持性能和容量均衡扩展,支持超智融合科学应用工作流数据共享高效处理。超智融合软件栈涵盖多精度混合并行运行系统软件、编译器、优化库和调度系统,其中STAR-Lance、STAR-Flux和STAR-Helix分别面向计算、通信和HPC-AI工作流提供性能优化和可扩展支持。在供电与散热方面,灵晟采用380 V直流供电和冷板式全液冷。
得益于上述从处理器核心到整机系统的全栈协同设计,灵晟以 2.1984 EFlops 的持续双精度浮点性能,位居 2026 年 6 月全球超算 TOP500 榜首,计算效率高达 80.37%;整机能效比达到 52.07 GFlops/W,在有限工艺条件下成功跨越 50 GFlops/W 门槛。在 HPCG 榜单中,灵晟以 22.0049 PFlops 同样排名第一,展现出高精度计算、稀疏访存、通信与计算能力之间的系统级平衡。
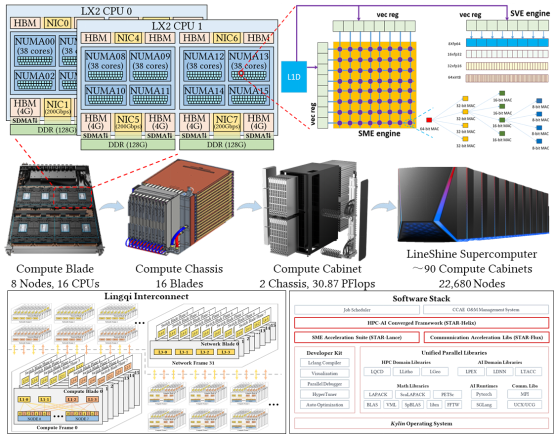
灵晟超算系统软硬件架构架构
科学应用
灵晟已服务于诸多领域的超智融合科学工程计算应用,论文通过四个案例展示其对不同科学任务的广泛适用性。在工程仿真领域,PowerLLEL通过高精度数值计算直接求解流体运动来研究壁湍流,实现了摩擦雷诺数约21,000的生产级模拟,创下公开文献中同类生产级模拟的最高雷诺数纪录,目前正向约43,000的更高目标推进。在脑科学领域,CerebroSim面对海量突触连接带来的稀疏访存和不规则通信,成为首个达到100万亿突触规模的全脑脉冲神经网络模拟器,能够在具有生物学约束和分层皮层结构的模型中模拟860亿个神经元和100万亿个突触。在药物设计领域,GLARE-Exa把AI与传统HPC计算组成闭环:AI负责生成候选分子,基于物理模型的分子对接负责评价,再将结果反馈给AI继续改进;这一流程仅用22.6小时便遍历了规模达10万亿种化合物的可合成化学空间。在遥感数据处理领域,D2AR把生成式AI与海量科学数据处理结合起来,先将对地观测数据高度压缩,再根据压缩表征按需重建;其63亿参数生成式重建模型训练的持续性能达到1.54 EFlops,最高可实现10,000倍数据压缩。
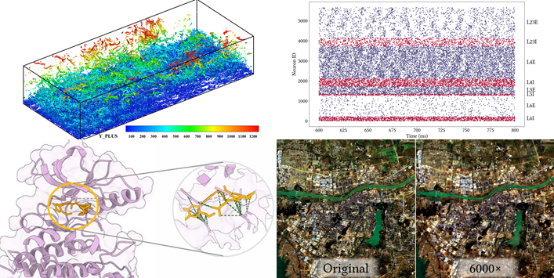
灵晟超算支撑的代表性科学应用
结语
在人工智能时代,超算系统需要适应科学工程应用中融合数值模拟、人工智能训推和大规模数据分析验证的闭环工作流新需求,灵晟给出了系统性创新方案。灵晟系统兼顾高性能、高能效和高可编程性,将支持AI的矩阵加速能力直接集成到众核CPU中,通过计算、网络、存储系统的大规模平衡设计,以及软硬协同优化设计的超智融合系统软件框架,支撑多领域大规模超智融合应用的高效运行。超智融合的灵晟系统为我国算力基础设施提供了全栈自主可控的样板,为国际超算技术发展提供了一条有别于传统异构加速架构的体系结构新路径,将进一步推动更广泛的科学与工程领域实现新突破。
视频介绍
主题:OnlineAccelerationforHPC-AIConvergedScientificComputing|灵晟&rdquo