
Kimi和DeepSeek,为什么出现在同一张模型架构图里?
 大模型 Attention 路线变迁:从分流到重组。
作者丨李娜
编辑丨岑峰
一张大模型架构图里,同时出现了 Kimi 和 DeepSeek 的影子。
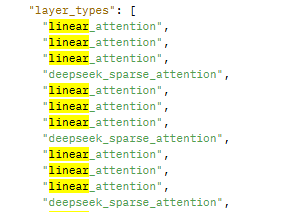 GLM-5.3-Flash项目配置文件:45层架构中,34层采用Kimi路线的KDA线性注意力,另外11层采用DeepSeek路线的KPool-DSA稀疏注意力
今年以来,大模型架构里出现了一条越来越清晰的变化:一些混合注意力架构中原本由全局Attention承担的角色,开始被Sparse Attention(稀疏注意力)接替。
要理解这个变化,得先回到 Attention 本身。
Attention解决的是一个基础问题:模型处理当前token时,能不能在越来越长的历史里,找到真正有用的信息。
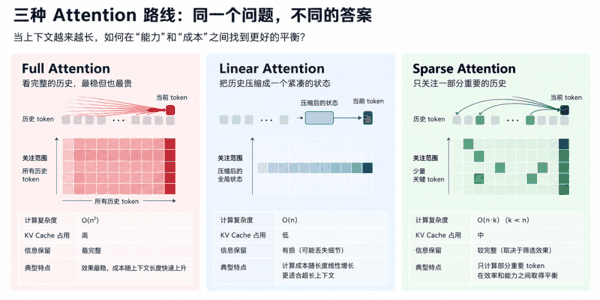 大致来看,目前常见的Attention机制可以理解成三类: 全局注意力(Full / Global Attention) 直接读取完整的token历史,信息保留最充分,但计算和缓存成本也最高; 线性注意力(Linear Attention) 把历史压缩进更紧凑的状态,以降低长序列的计算成本; 稀疏注意力(Sparse Attention) 则保留更完整的历史,只选择其中一部分重要信息参与计算。过去几年出现的很多 高效注意力(Efficient Attention) ,主要就在后两种方向上继续演化。
最开始,经典 Transformer 主要使用 Full Attention,Full Attention让模型可以直接访问完整的token级历史,代价是计算和KV Cache随上下文迅速增长。连带着训练和推理成本也随之大幅增加。
过去几年,大家对 Attention 的改造,本质上都是在能力和成本之间找平衡。于是,作为折中方案的混合注意力架构逐渐流行起来:不同机制被放进同一套模型里分工,高效Attention负责降低成本,少量全局Attention保留直接访问完整历史的机会。
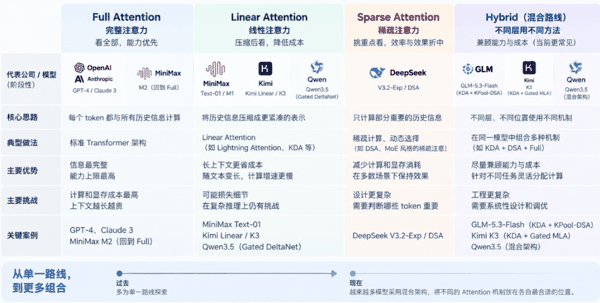 从不同Attention路线,看大模型公司的选择 到了今年,很多混合注意力架构里由全局Attention承担的角色,开始出现被Sparse Attention接替的迹象。
8月发布的Qwen3.8-Flash-Next就是一个很清楚的例子。它延续此前三层 Gated DeltaNet 配一层 Attention 的结构,但那一层原本负责全局精确读取的 Attention,被进一步改造成了 Qwen Sparse Attention这样的高效注意力机制。 雷峰网 (公众号:雷峰网)
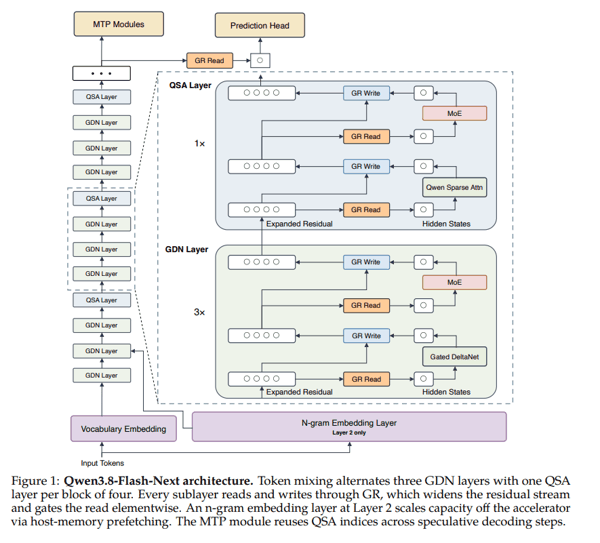 Qwen3.8-Flash-Next 架构图:每四层里,三层是 GDN,一层是 QSA 为什么那层一直被认为无法替代的全局 Attention,也开始有人尝试用另一种高效机制接替?如果具体的 Attention 技术正在变成可以流动和重组的零件,我们今天所谓一家模型公司的“技术路线”,到底还指什么?
 01
MiniMax最后还是留下了Full Attention
要回答这个问题,可以看看MiniMax过去几年的架构变化,几乎完整经历了这一轮反复:从押注线性注意力,到保留少量全局注意力做混合注意力,再回到全局注意力,后来又转向稀疏注意力。每一次变化背后,都对应着模型Scale以后新暴露出来的问题。
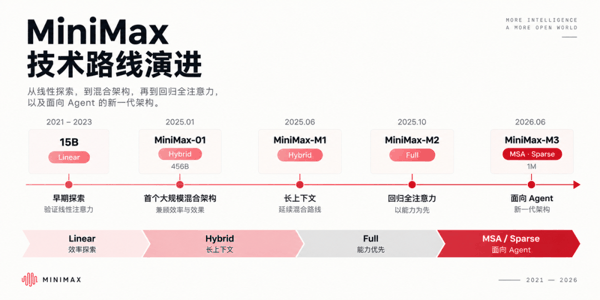 2023年底,后来主导过MiniMax-01网络架构设计的钟怡然正在给Linear Attention找一家愿意真正把它Scale Up的公司。
他从2021年开始研究这条路线,此前最大的实验模型已经做到15B。在他看来,Linear Attention在建模效果和运行效率上的几个主要问题已经基本解决,真正剩下的问题只有一个: 它被放大到几百B参数以后,还能不能成立?
这个问题已经不是研究团队自己可以回答的了。
预训练一个几百B参数的大模型,架构一旦确定,数据、算法、训练系统和工程资源都会跟着转向。钟怡然此前也接触过其他公司,最终在2023年底和闫俊杰的一次交流后,MiniMax决定把这条还没有经过大规模验证的路线接下来。
双方对这件事的把握其实并不一样。
钟怡然后来回忆,作为长期研究Linear Attention的人,他当时觉得成功概率接近99%;但站在闫俊杰的位置上,他估计这个数字只有大约一半。一旦把Linear作为下一代主模型的架构,MiniMax超过80%的研发资源都会被卷进来。 一家大模型公司要用绝大多数研发资源,去验证一件只有五成把握的事。
 MiniMax创始人闫俊杰,图源网络 早期实验一度让这场下注显得没有那么危险。团队曾经训练过一版15B左右的纯Linear模型,效果已经可以接近Transformer,似乎说明这条路线可以继续往上Scale。 但模型进一步放大后,问题开始暴露出来 。 Linear Attention为了降低长上下文的计算成本,会把历史信息压缩进更紧凑的状态里,而在检索这类需要从很长文本中准确找回某个细节的任务上,这种压缩会出现问题。
Linear Attention省下计算的关键,在于它不会一直保存并重新读取每个历史token,而是把过去的信息不断压缩进有限的状态里。这样做很像把一本书边读边做笔记:记住主题和大意很高效,但如果几百页以后突然问“第37页某句话具体写了什么”,压缩过的笔记未必还能完整还原。
MiniMax原本希望把Linear做得更彻底,最后还是把Full Attention加了回来。
后来MiniMax-01采用的7:1 混合注意力架构由此出现:每7层Lightning Attention之后,加入1层传统SoftMax Attention。大部分计算交给更便宜的Linear Attention,但模型隔一段仍然获得一次直接读取完整上下文的机会。
这个比例是在不同层数和组合之间反复实验后找到的折中。钟怡然后来把混合注意力形容成一种“保底方案”。
可是,15B模型给出的信号仍不足以支撑一轮4560亿参数的正式训练。在真正开跑MiniMax-01之前,团队做了 大约3700次预训练实验 ,不断改变模型大小、架构和参数组合,再从这些相对便宜的小实验中判断Scaling Law是否还能继续成立。
2024年中,MiniMax最终开始训练4560亿参数的MiniMax-01。到2025年1月模型发布时,7层Lightning Attention加1层Full Attention的架构被正式保留下来,上下文长度也被推到了400万token。
MiniMax花了数千次实验和一轮大规模预训练,最后仍然没有把那层Full Attention拿掉。它恰恰解释了为什么在后来很长一段时间里,混合注意力 Attention虽然越来越常见,却往往仍要保留少量全局Attention。
而MiniMax很快还会第二次碰到这个问题。