
NVIDIA在OCP开放Vera Rubin机架设计:250 kW机架的供电、液冷与运维接口被收进同一份规格
NVIDIA 10 月 12 日在圣何塞举行的 OCP 全球峰会上宣布,通过 Open DC Initiative 把 Vera Rubin 的 机架 与计算托盘设计贡献给开放计算项目,构成第三代 MGX 参考设计。更新的 MGX 1.2 规格包含 机架 级盲插 液冷 、可互操作的 机架 级互连基础设施与面向高功率系统的 液冷 5,000A 母排 ,新增原生 19 英寸设备支持与更高密度机架设计,并给出可配置 I/O 仓、无风扇 液冷 计算托盘与统一的供电、冷却接口,支持最高 250kW 的机架部署。公司同期发布 Vera CPU 机架设计规范,把这条开放路径从 GPU 机架延伸到面向智能体负载的机架形态,用于工具调用、任务编排与沙箱化执行。
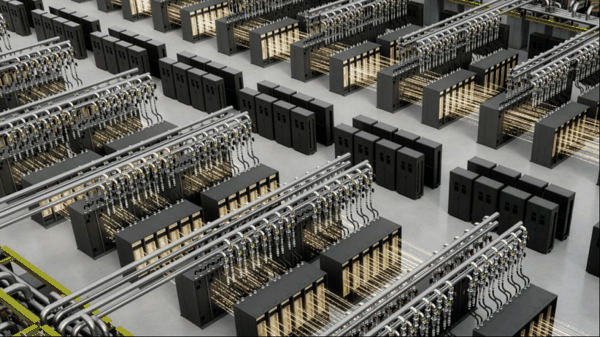 NVIDIA OCP 峰会机架与液冷说明配图 图片来源: NVIDIA
250kW 这个数量级改变了机架接口的定义方式。机架功率停留在数十千瓦时,供电与散热主要在机房侧解决,机架内部要处理的是计算与网络互连;当单机架功率推到 250kW、 母排 电流达到 5,000A, 母排 、盲插液冷接头与机架间互连就成了必须在机架设计阶段固定下来的机械与电气接口。规格把"盲插"单列,对应的是液冷回路与电力连接在机架推入时一次对接完成,现场减少接管作业,装配、测试与维护的节拍随之改变。Vera CPU 机架与 GPU 机架共用同一套机架级设计原则,把计算、网络、供电与冷却放进同一个模块化平台,同一机架框架可以承载两类托盘。
软件一侧开放的是 DSX OS 的四个组件:Config Manager 自动化交换机配置,Cluster Readiness Engine 用接近真实负载的模拟对 GPU 集群做压力测试、在训练任务启动前暴露硬件问题,Rack Management Service 把整机架当作管理单元处理固件与运维,Cluster API Provider for NVIDIA Infrastructure Controller 负责裸金属编排与租户接入,把裸机到生产集群的时间从数天压缩到数小时。这些组件来自 NVIDIA 运营 DGX Cloud 的经验,与硬件规格一起,把开放范围从托盘和机架机械结构扩到网络配置、集群验证与机架运维。
把机械接口、供电、液冷与运维软件放进同一份开放规格,直接影响的是连接器、母排、CDU、测试测量与数据中心设施这些机架外围环节,它们此前各自跟随不同厂商的私有设计,接口一旦统一,选型与二次开发的起点会变。另一面,规格开放也让机架级互操作的验证工作从厂商内部转移到采用方,谁的文档、测试夹具与故障定位手段更完整,会体现在部署周期上。设计贡献与开源仓库不等于客户已经完成量产部署,Config Manager 目前处于开发者预览状态;NVIDIA 未公布定价、Vera Rubin 系统的正式可用时间,也没有第三方独立性能数据。