
RSI火了,但自进化也会过拟合:Google等提出RRSI,给自进化施加正则化
最近,Recursive Self-Improvement(RSI,递归式自我改进)正在迅速成为 Agent 领域最受关注的方向之一。
过去谈 RSI,我们很容易想到一个颇具未来感的场景:AI 修改自己的模型,再用更强的自己继续改进下一代系统。但真正落到今天的 Agent 上,RSI 已经有了一条更现实的路径 —— 不需要先修改模型权重,Agent 可以先修改 “模型外面的自己”。
Prompt 怎么写、什么时候调用工具、如何管理 Context 和 Memory、失败后怎么恢复、什么时候反思、什么时候停止…… 这些围绕模型构成的 Agent Harness,本身就决定了同一个基础模型最终能做成多少事情。
于是,一个很自然的闭环出现了:Agent 执行任务,观察失败,自动修改 Harness;修改后的 Agent 再执行任务,再根据新的反馈继续修改。这已经是一种真实发生在 Agent system level 的 Recursive Self-Improvement。
但问题也随之而来:如果一个 Agent 一轮又一轮地根据同一批任务修改自己,它到底是在 “进化”,还是只是在越来越会做这套题?
 论文链接: https://arxiv.org/abs/2609.24972
GitHub 链接: https://github.com/google-research/rrsi
项目主页: https://regularized-rsi.com/
RSI 最大的隐患:越改越强,还是越刷越熟?
现有 Harness Evolution 通常遵循一个很直观的流程:先让当前 Agent 在一组任务上执行,根据成功和失败轨迹产生 feedback;然后让 LLM 修改 Harness,再把新的 Harness 放回同一批任务上评测。分数更高的版本留下来,进入下一轮。
问题是,这批 evolve tasks 会被一遍又一遍地使用。第 1 轮 Harness 的修改来自这些任务,第 2 轮又根据修改后的表现继续优化,第 10 轮、第 30 轮依然如此。整个过程逐渐变成了一个对有限数据持续进行的 adaptive search。
论文指出,这会带来 三类耦合问题:benchmark-specific fitting、evaluation noise chasing,以及 complexity accumulation 。Agent 可能记住当前 Benchmark 独有的 pattern,也可能把随机涨分误认为真实 improvement,甚至不断增加 Prompt、Context 和控制逻辑,用越来越多的 test-time compute 换取 evolve set 上的一点点提升。
最终就会出现一个非常反直觉的现象:evolve score 持续上涨,但真正离开 Evolution Set 后,收益却迅速缩水,甚至消失。
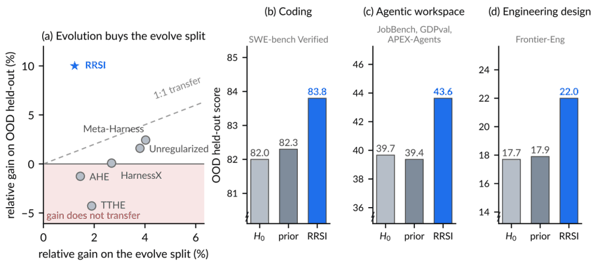 图 1|Evolve Set 上的提升,并不等价于 OOD 上的提升。
真正的问题不是 “Harness 能不能持续变高分”,而是这些改动离开反复见过的任务后,还剩下多少。
RRSI:不是限制 Agent 能改什么,而是 Regularize “它怎么改自己”
RRSI(Regularized Recursive Self-Improvement of Agent Harnesses)的关键设计,是 没有把 Agent 的自我修改能力锁死。
Prompt 可以改,Control Flow 可以改,Tool 可以改,Memory、Skill、Context Management 可以改,甚至 Subagent 也可以增加或删除。换句话说,Agent 依然拥有一个开放的 self-modification space。
RRSI 真正 regularize 的,是 Agent 在这个空间中 “如何搜索”。它把 Harness RSI 拆成两个问题:Proposal 负责决定 “下一轮应该尝试改什么”,Selection 负责决定 “哪些修改真的有资格成为永久状态”。
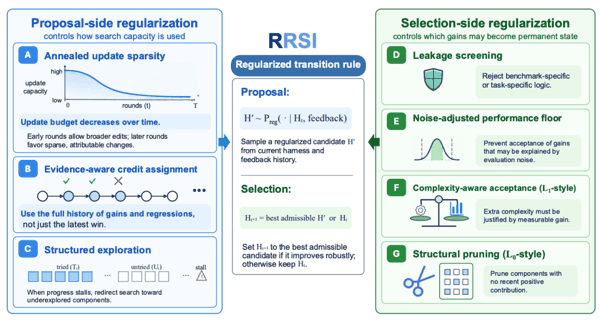 图 2|RRSI 同时 Regularize Proposal 与 Selection,而不是限制 Harness 的可编辑空间。 在 Proposal 端,RRSI 首先限制一次 Self-Improvement 可以同时塞进多少相互纠缠的修改。前期允许更广泛的探索,但随着 Evolution 推进,每一轮允许同时修改的机制越来越少,让后期的每一次变化更容易归因。
同时,它会保留完整的 Evolution History:过去哪个 hypothesis 成功过、哪个机制已经失败过、某次修改增加了多少 score、付出了多少 cost,都会继续成为下一轮 Search 的 evidence。搜索长期停滞时,还会把部分 capacity 转向此前较少被探索的 Harness component。
Selection 端则更加严格:一个 Candidate 并不会因为 “分数涨了” 就自动成为下一代 Harness。Benchmark-specific 的改动会被提前筛掉;落在 evaluation noise 范围里的涨分不会轻易写入永久状态;额外增加的 Context 和 Token 必须用足够的 Performance Gain 证明价值;长期没有贡献的机制还会被直接 Prune。
换句话说,RRSI 不是阻止 Agent 变化,而是要求每一个想永久留下来的变化都 “证明自己”。
一个很反直觉的结果:Evolve Score 更高,反而进化得更差
这篇论文里最值得看的,并不是某个 Benchmark 又涨了几个点,而是下面这组 Ablation。
在 Agentic Workspace 上,如果去掉 Regularization,普通 Unregularized Evolution 可以把 evolve score 推到 92.8,高于 RRSI 的 90.5。如果仍然用传统的 “训练分数越高越好” 来判断,前者看起来显然更成功。
但到了三个完全不参与 Evolution 的 OOD Benchmark,结果反了过来:Unregularized Evolution 的 OOD Average 只有 40.3,而 RRSI 达到 43.6。与此同时,前者每个 Trial 需要 3.80M Policy Tokens,RRSI 只有 2.42M。
也就是说,更高的 Evolve Score 并没有带来更好的 Self-Improvement,反而对应更差的 Transfer 和更高的 Inference Cost。