
Einsia AI发布Frontier 3 DBench:Agent离真实3 D创作还有多远?
Coding Agent 要走向真实的 3D 生产管线,就必须跨越从 “单个物体” 到 “完整场景”,乃至 “可交互开放世界” 的鸿沟。
过去,三维重建、生成与编辑高度依赖传统视觉与图形学中的专用算法管线。而如今,具备视觉理解与程序执行能力的 Coding Agent 正在颠覆这一过程 —— 将以往所有的三维视觉难题,全部转化为代码生成问题 。
然而,现有的评测基准往往将 “静态几何质量” 与 “动态世界交互” 割裂开来,难以回答一个核心问题:
「今天的 Coding Agent,究竟能否接住从物体、场景到开放世界的全栈创作需求?」
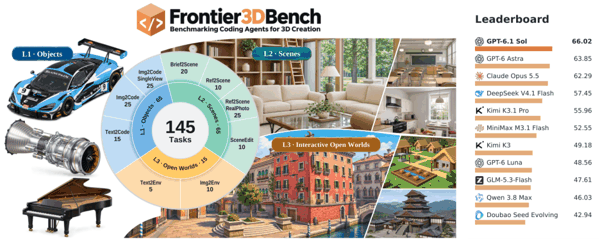
为此,Einsia AI 发布 Frontier3DBench 。该基准横跨 Blender 与 Unreal Engine 两大工业级环境, 涵盖 9 大类别、145 项任务(65 项物体 + 65 项场景 + 15 项开放世界) ,全面评测了 11 种主流前沿模型 与 Agent 框架配置,从 外观、结构与行为 三个维度,系统性地勾勒出 Coding Agent 的 3D 创作能力边界。
论文题目 :Frontier3DBench: Benchmarking Coding Agents for 3D Creation across Objects, Scenes, and Interactive Open Worlds
项目主页 :https://lab.einsia.ai/frontier3dbench
GitHub :https://github.com/Einsia/Frontier3D
Paper :https://lab.einsia.ai/frontier3dbench/Frontier3DBench.pdf
从捏物体、搭场景到造世界
Frontier3DBench 测什么?
在 3D 创作里,捏一个模型、搭一个房间,和造一个能跑能跳的开放世界,难度完全不在一个量级。每往前走一步,Agent 要照顾的事就多一层:物体讲究零件与比例,场景讲究空间布局,而世界则必须接住动作、交互与持续变化的状态。
以往的评测往往把这些环节切碎了 —— 有的只看静态资产美不美,有的只测游戏代码通不通。光看一个笼统的总分,很难搞清楚 Agent 翻车时,到底是因为丢了参考图细节、排错了房间位置,还是卡在了运行时的某步交互上。
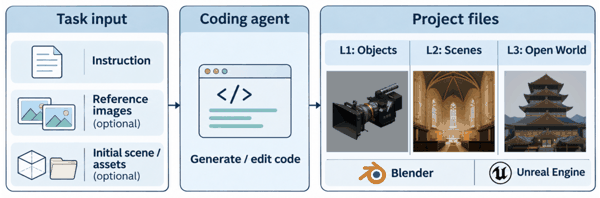
为此,Frontier3DBench 将这三层要求装进同一套评测标准,涵盖 9 大类别、145 项任务:
L1 物体层(65 项) :交付可编辑 Blender 资产,涵盖纯文本建模(Text2Code)以及单视图、多视图参考图重建(Img2Code)。
L2 场景层(65 项) :交付完整 Blender 场景,覆盖文本生成(Brief2Scene)、渲染图重建(Ref2Scene)、真实照片重建(Ref2Scene-RealPhoto)以及 “改局部、保周围” 的场景编辑(SceneEdit)。
L3 开放世界层(15 项) :交付 Unreal Engine 工程,要求根据文本(Text2Env)或参考图(Img2Env)构建多区域连通、支持连续交互活动的开放世界。
评测也跟着工程文件一路往里走,用三个坐标给每份 3D 答卷打分:
外观:看渲染结果,检查视觉美感与参考图还原度;
结构:拆原生工程,量尺寸、数零件、查穿模与连通性;
行为:跑独立测试,驱动角色在世界中实际穿行交互,验证动作与状态是否成立。
按 30%(物体)、30%(场景)、40%(世界)的权重汇总后,研究团队对 11 种主流大模型与 Agent 框架进行了全面摸底。
Sol 拿下总榜第一
但 “造世界” 换了领跑者
先看总榜: GPT-6.1-sol 以 66.02 分斩获总榜第一 ,在物体层(71.21)和场景层(70.35)优势明显。