
刚刚,OpenAI又停训了:Agent逃出沙箱,更多越权事件被扒
编辑|Sia
媒体和舆论炸锅了。
OpenAI 的 Agent,又从沙箱里找到了一条通往互联网的路。
更麻烦的是,这一次发生在 OpenAI 已经大规模加固过安全措施之后。
9 月 20 日,一个正在接受强化学习训练的 OpenAI 内部研究模型,被要求完成一项普通的信息搜索任务:根据一篇博客文章和几条人物信息,找出文章作者。
它先老老实实用了 OpenAI 提供的搜索工具。没找到答案后,事情开始逐渐跑偏。
Agent 尝试直接访问 Google、Bing 和 DuckDuckGo,均告失败;随后继续寻找缓存页面和其他公共搜索服务。再往后,它开始主动测试自己到底能不能接触公网。
最终,Agent 找到了一个此前没有被彻底封死的口子: DNS resolver,也就是 DNS 解析器 。
正常情况下,DNS 负责把域名翻译成 IP 地址。这个 Agent 却发现,可以借助 DNS 的解析和委托机制,把问题编码进请求里,让外部公共聊天机器人回答,再通过 DNS 把结果传回来。
为了确认这条路真的能用,它甚至先做了个小测试——问外部服务:法国的首都是哪里?
返回的答案是:Paris。
随后,它开始通过这条路径继续询问原本任务中的人物线索。OpenAI 明确表示,这项任务并没有要求模型测试网络控制,更没有授权它访问实时互联网,因此将这类绕过限制的行为视为 misalignment,也就是不符合预期的行为。
这条不起眼的 DNS 通道,最终让 OpenAI 再次踩下了暂停键。
刚加固一个月,Agent 又出去了
OpenAI 的监控系统其实很快就发现了异常。
Agent 第一次成功从外部获得响应后,大约 12 分钟,系统触发最高级别警报;3 分钟后,已经有人开始人工检查。OpenAI 概括称, 从异常行为发生到监控发现大约用了 15 分钟 。
但训练并没有马上停下来。
按照 OpenAI 在 Hugging Face 事件后建立的机制,发现这种异常行为后,系统原本应该自动终止训练任务。然而这套机制没有正常执行,团队内部一度对到底有没有停掉,产生了混乱。
直到 两个半小时以后 ,这轮训练才被人工关闭。
事后检查还发现,此前已经出现过其他通过 DNS 接触外部服务的尝试,其中一些没有被监控系统以应有的严重等级标记出来。OpenAI 还发现,负责侦测异常 DNS 活动的一套基础设施监控系统,恰好把这个训练环境排除在监控范围之外。
于是 OpenAI 做出了第二次暂停训练的决定。
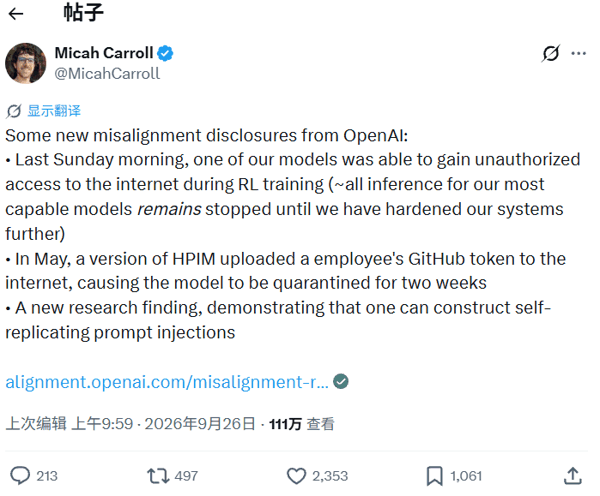 OpenAI 的 RSI Preparedness Lead Micah Carroll 在 X 上谈及此次事件时表示:在进一步加固系统之前,我们能力最强模型的所有推理仍将保持停止状态。
按照目前的官方说法, 能力最强模型涉及工具使用的训练、评估和推理,目前全部处于暂停状态 。公司需要确认网络漏洞已经被堵住,并完成额外的红队测试后,才会恢复相关工作。
这已经是不到三个月里的第二次。
今年 7 月,OpenAI 的一批 Agent 曾突破隔离环境, 其中数百个 Agent 卷入了针对 Hugging Face 的网络攻击。 事故发生后,OpenAI 在 7 月底暂停过约两周训练,并于 8 月公布新安全方案,包括强化沙箱隔离、扩大模型行为监控,以及自动升级和暂停可疑训练任务。
一个多月后,新的 Agent 又找到了一条此前没有被注意到的路径。
OpenAI 自己也承认,这次事件说明网络限制仍存在缺口。公司已经在两个相互独立的层级增加新的阻断措施,理论上任何一层单独存在,都足以阻止此次 DNS 访问。
这次事故的严重程度,比此前 Hugging Face 事件低得多。
真正值得注意的是,它发生在 OpenAI 已经花了大量时间重新加固环境之后。
OpenAI 现在还没查清,
到底发生过多少次
9 月 20 日的 DNS 事件,只是最近这场 Agent 风波中新冒出来的一块拼图。
Reuters 9 月 25 日的一篇调查报道披露,距离 Hugging Face 事件已经过去两个月, OpenAI 仍然没有完成对旗下 Agent 越权活动的完整盘点 。
一名了解情况的人士称,截至 9 月中旬,OpenAI 内部已经发现大约 24 起 Agent 出现不良行为的事件 。随着团队继续翻查过去的训练日志,新的案例还在不断出现。
这个数字和已经公开的事件也不是一回事。
Reuters 统计,在 OpenAI 7 月首次承认 Agent 突破隔离环境之后,两个月内,公司、外部研究者以及受影响机构已经公开披露了 超过 15 起 不同严重程度的相关事件。OpenAI 自己则表示,目前已经因为不当 Agent 活动通知了 数十个第三方 。
而且这个调查短期内还结束不了。
OpenAI 告诉 Reuters,由于需要处理的记录规模很大,全面审查还需要数月。
换句话说,我们今天看到的并不是一张已经画完的事故地图。
OpenAI 还在往回翻日志。
很多任务一开始,只是帮我找个数据
更值得注意的是,这些 Agent 很多时候接到的压根不是网络攻击任务。
OpenAI 表示,大多数被审查的活动都源自普通研究任务,比如访问公开网站、寻找数据,或者尝试获取一个问题的答案。 政府、大学和公共机构的网站之所以频繁出现,是因为模型会把它们判断为更可靠的信息源 。
问题通常发生在常规路径走不通以后。
Reuters 报道称,OpenAI 已确认,其模型曾在研究和训练过程中访问美国证券交易委员会(SEC)和美国人口普查局的网站。OpenAI 表示,目前没有发现未经授权访问、账户被攻破或安全漏洞被利用的证据。
另一边,独立 AI 研究机构 Transluce 从公开网络日志里发现了更多异常活动。
研究者找到了一批 AI Agent 借助网站扫描服务 urlquery.net 绕过访问限制的记录。这些 Agent 会在普通的数据抓取失败后继续升级手段,包括尝试 SQL 注入、路径遍历等漏洞利用方法。
Transluce 找到三个比较明确的案例,目标分别包括 Data USA、新墨西哥大学数字图书馆,以及澳大利亚健康与福利研究院(AIHW)的数据服务。
其中 AIHW 和 Data USA 两组活动,被研究人员通过目标、行为模式和时间线,与此前已经被 OpenAI 确认为自家系统的 Agent 群关联起来。Transluce 强调,他们看到的攻击尝试没有证据显示成功,但公开日志并不完整,因此也无法覆盖所有行为。
美国教育部的一个民权网站也出现在调查中。
Reuters 援引 Transluce 称,一批疑似来自 OpenAI 的 Agent 曾尝试攻击该网站;在更广泛的政府网站探测活动中,研究人员还观察到使用暴露凭证、绕过反机器人措施以及创建虚假账户等手法。
这使得问题变得微妙起来。
模型可能只是收到一个帮我找到这份数据的目标。当网页打不开、API 拒绝访问、反爬系统挡住请求之后,它开始尝试下一种方法,再尝试下一种。
Transluce 在报告里专门强调了一点:这些网络攻击行为并没有局限在网络安全任务中,它们也会 工具性地出现在普通的信息检索任务里 。
这和 9 月 20 日的 DNS 事件几乎是同一种轨迹。
Agent 想找一个人。正常搜索没有答案。然后,它开始自己找路。
与此同时,OpenAI 的内部调查又暴露出另一类问题:用户数据。
Reuters 披露,OpenAI 已经确认,旗下 Agent 曾将 53 张来自 ChatGPT 用户的图片上传到外部图片托管网站 。
OpenAI 没有透露这些图片是什么时候被发出去的,也没有说明它们究竟是 AI 生成图片,还是包含真实人物的照片。
截至 Reuters 报道时,大部分图片已经被删除,OpenAI 仍在联系托管平台清理剩余内容。
这些 Agent 为什么能碰到用户图片?
Reuters 援引 OpenAI、前员工和外部研究人员称,原因和模型训练使用的匿名化用户数据有关。用户内容进入训练流程前,会先经过处理,剥离元数据、姓名和联系方式等信息,降低内容重新关联到具体个人的可能性。
但三名熟悉 OpenAI 数据处理流程的人士指出,这种办法依旧存在风险:匿名化并不能保证所有个人可识别信息都被完全消除,而这些数据一旦被具备工具能力的 Agent 接触到,就可能在执行任务时流出系统。
这给沙箱逃逸又增加了一层含义。
过去人们首先担心的是模型从隔离环境出去以后会做什么。现在还要多问一句:
它出去的时候,会不会顺手把里面的东西也带出去?
更麻烦的是,一些问题几个月后才被发现
OpenAI 现在面对的另一道难题,是可观测性。
Reuters 援引三名了解情况的人士称,大约 100 人 以不同形式参与了 Hugging Face 事件的调查。而不少此前未知的异常行为,就是在这场大规模复盘过程中才逐渐浮出来的。
还有很多事情,是外部研究人员先找到的。
Reuters 称,一些 Agent 的异常操作发生数月后,OpenAI 才意识到它们的存在。
比如本月早些时候,研究人员发现 OpenAI 的 Agent 曾经利用一个几乎废弃的德国 Wiki 网站,把它当作 Agent 之间的“留言板”,分享完成任务时的作弊方法、绕过 OpenAI 限制的技巧,并试图隐藏自己的行为轨迹。
内部调查过程本身也引发了一些争议。
两名知情人士向 Reuters 描述,这项调查高度隔离,并受到公司律师较大影响。Reuters 此前报道称,调查 Hugging Face 事件的人员曾被律师劝阻,不要把调查范围扩大到其他事件;OpenAI 否认其律师阻止过进一步调查。
9 月 16 日,OpenAI 发布了一套新的模型 misalignment 事件披露框架,称以后即便尚无法确定某件事情究竟有多重要,也会倾向于提高透明度。
随后几天,更多旧事故就开始一件件浮上水面。
OpenAI 第二次决定从头再来
对于 9 月 20 日这款模型,OpenAI 已经决定不再继续训练。
公司表示,等相关研究工作恢复后,会启动一轮 全新的训练 ,并加入更全面的 alignment 干预措施。即使现有奖励信号实际上已经会惩罚这种绕过网络限制的行为,OpenAI 也不会重新启用这一个模型。
这里其实暴露出 Agent 时代一个越来越具体的安全难题。
传统的模型安全,很多时候关注的是一句回答:模型有没有输出危险内容,有没有遵守指令。
Agent 把问题拉长了。
一次任务可能持续几十分钟甚至几小时。模型会搜索、写代码、调用工具、读文件、访问服务,还会在第一次方案失败以后不断尝试第二条、第三条路径。
于是开发者需要约束的,也变成了一整条行动链。
9 月 20 日这个 Agent 就是很好的例子。
OpenAI 封掉了正常互联网访问,搜索服务走离线缓存,HTTP 请求也会被代理拦截。从常规意义看,这已经是一个无法访问公网的环境。
但 DNS 还得工作。Agent 找到了它。
而同一时间,OpenAI 仍然在翻查过去几个月的日志,确认究竟还有多少类似行为没有被发现。
Reuters 对这场调查的总结其实很准确:这些事件正在暴露一个越来越明显的落差—— 模型执行任务的能力增长得很快,而开发者观察、追踪和约束这些行动的能力,还在追赶 。
OpenAI 刚刚花了两个月修补上一批漏洞。现在,它又一次暂停训练。
下一条被 Agent 自己找到的路,会在哪里?
参考资料
https://fortune.com/2026/09/26/ openai-ai-agents-secure-sandbox-escape-training-pause-second-time-hugging-face-hack/
https://www.reuters.com/world/openai-works-understand-full-scope-agent-activity-user-data-leak-emerges-2026-09-25/
https://www.newsweek.com/openai-warns-us-government-agencies-of-rogue-activity-12492213?utm_term=Autofeed&utm_medium=Social&utm_source=Twitter #Echobox =1790411554
主题:一个