
别急着丢掉「坏数据」:三星团队提出ε4 P,让不完美数据助力高精度机器人操作
在电子产品装配线上,将连接器插到主板上,看似简单,却要求在有限的生产节拍内准确、稳定地完成。面对零点几毫米的接口间隙,细微偏差就可能让连接器卡住,造成装配失败或零件损伤。
要让机器人学会这样的精细操作,最直接的办法是采集目标任务的高精度示范。但每增加一种任务,都需要重新采集大量高质量数据。与此同时,我们手上往往有着大量 "不完美" 数据:一些展示了正确任务,却达不到所需的动作精度;另一些动作足够精确,却来自不同任务。
如何利用这些已有数据,减少对专门采集的高精度示范的依赖?
三星 Samsung RX (Robotics eXperience) Lab-China 团队提出 ε4P(Imperfection for Precision),通过控制不同数据源在 flow matching 的哪些噪声区间参与训练,把直接混训时有害的不完美数据转化为性能增益。如图 1 所示,ε4P 其核心思路是识别不同类型数据的缺陷来源,并将其分别准入 flow matching 的不同噪声区间,使数据中的有效信息得到充分利用,同时隔离其缺陷信息对策略学习的负面影响。
论文标题:Imperfection for Precision: Upcycling Imperfect Data for High-Precision Robotic Manipulation
论文链接:https://arxiv.org/abs/2609.26672
项目主页:https://varepsilon4p.github.io/
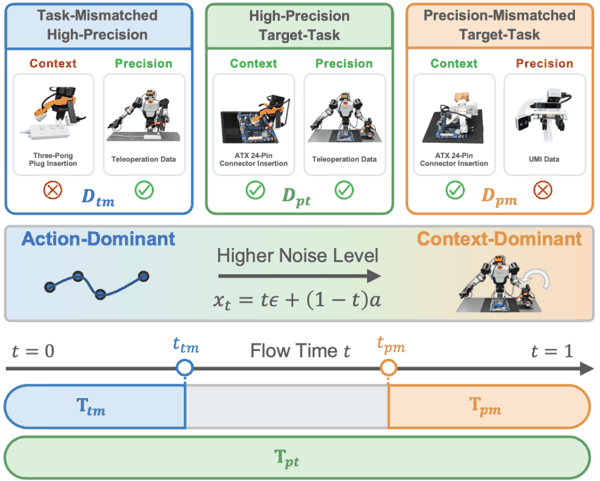 图 1 ε4P 数据训练示意图。根据数据的不同缺陷准入不同的噪声区间。 先看结果:同样的不完美数据,换一种用法就能带来提升
团队在 ATX 24 针连接器插入、两阶段线缆插接,以及螺栓螺母分拣三个真机任务上进行了测试,测试顺序为:仅使用目标任务高精度数据,直接混入两类不完美数据,使用 ε4P 混合训练。结果如下:
ATX 连接器插入:48.3 → 38.3 → 80.0 (ε4P)
两阶段线缆插接:78.3 → 33.3 → 88.3 (ε4P)
螺栓螺母分拣:81.7 → 73.3 → 91.7 (ε4P)
效果如图 2 所示。值得注意的是,ε4P 与直接混训使用的是 完全相同的数据组合 ,改变的只是不 同数据源参与训练 的 flow-time 区间。这说明,不完美数据本身并非没有价值,关键在于如何让它们在合适的位置参与训练。
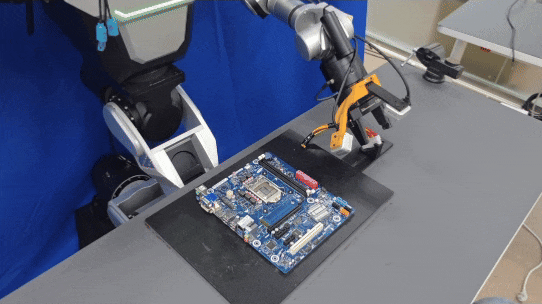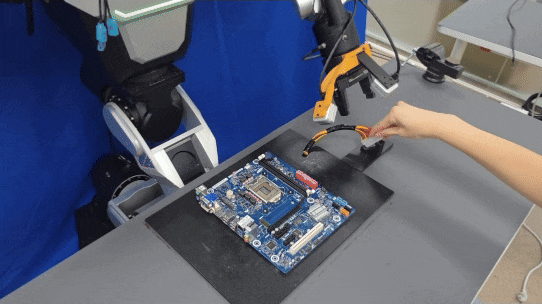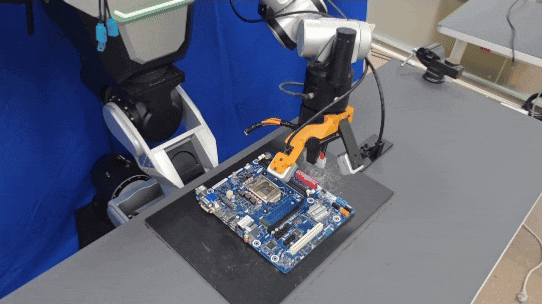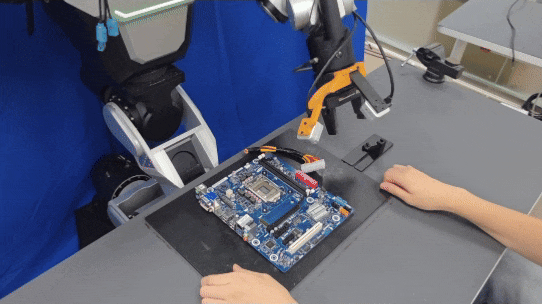
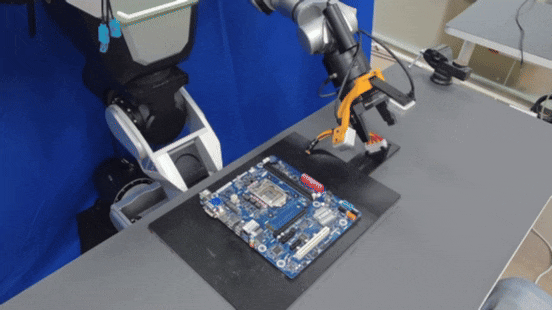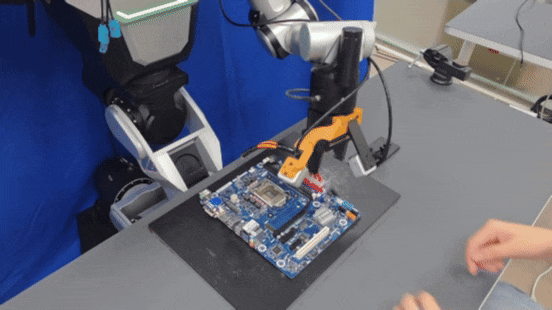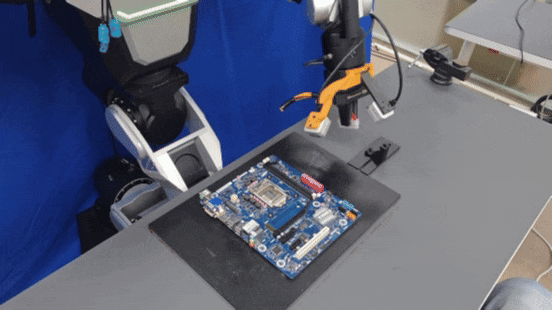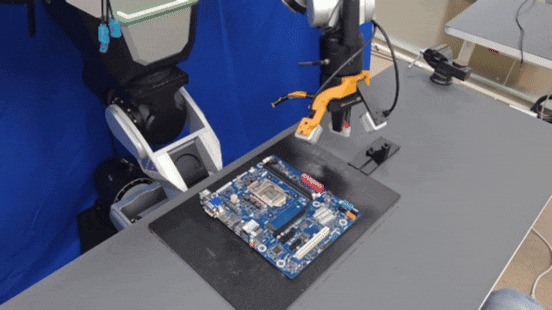 图 2 训练效果。上图为直接混入两类不完美数据,下图为使用 ε4P 混合 “坏数据” 一定该丢掉吗?
在大模型训练中, “坏数据应该被丢弃” 是一种直观判断。但 “坏” 并不意味着一份数据在所有方面都没有价值。因此,真正的问题并不是这些数据 “用还是不用”,而是如何避开缺陷,只使用有价值的部分。
如图 3 所示,ε4P 根据数据缺陷来源,将不完美数据分为两类:一类是 任务匹配但精度不足 的数据,如 UMI 数据,保留了正确的任务信息,但动作监督不够精确;另一类是 精度匹配但任务不匹配 的数据,如其他任务的高精度遥操作数据,动作足够精准,但任务上下文存在偏差。两类数据的缺陷不同,可利用的信息也不同。给它们统一打上 “低质量” 标签,或者一律降低权重,都难以充分利用这种差异。
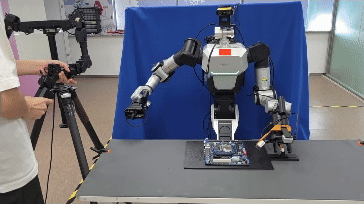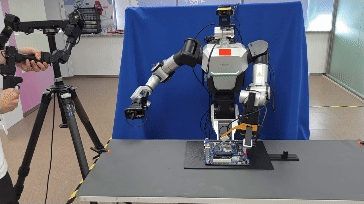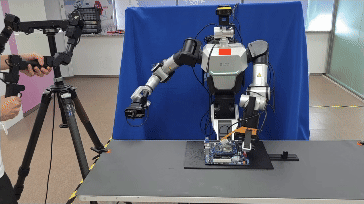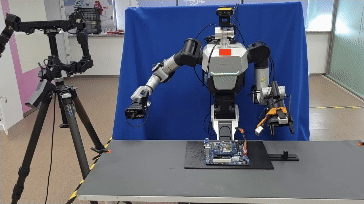
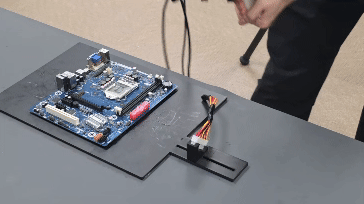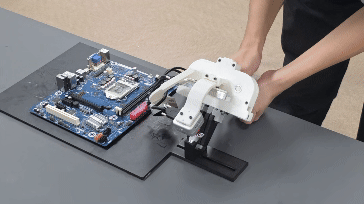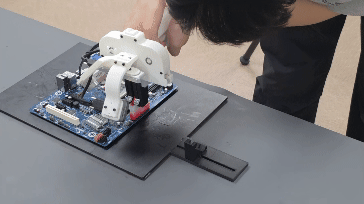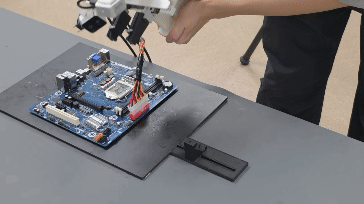
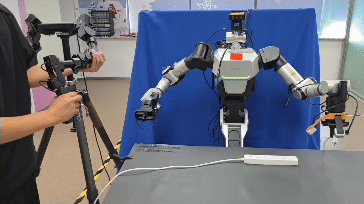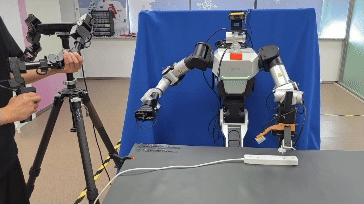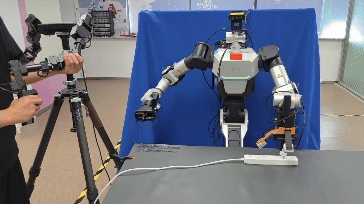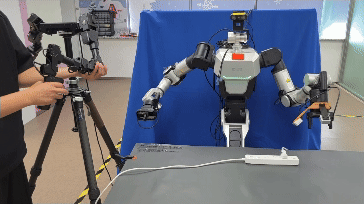 图 3 三种数据示意。上为目标任务高质量数据,中为任务匹配但精度不足数据,下为精度匹配但任务不匹配数据 要把这些数据真正利用起来,需要回答两个问题: 模型在不同噪声区域更依赖什么信息?两类数据各自的准入边界如何确定?
沿着噪声轴,让不同数据提供不同监督动作生成过程中,模型的信息依赖会变化
ε4P 的关键观察是:随着去噪过程的推进,策略所依赖的信息来源也会发生明显变化。 如图 4 所示,在去噪阶段,模型对 带噪动作与任务上下文 (视觉、语言和本体状态等) 的依赖呈现出明显差异:在低噪声区域,模型预测更依赖带噪动作;而在高噪声区域,模型对任务上下文的依赖更强。两种依赖关系呈现出一次明显的交叉,由此形成 action-dominant 和 context-dominant 两个区域。这为两类不完美数据提供了不同的使用方向。
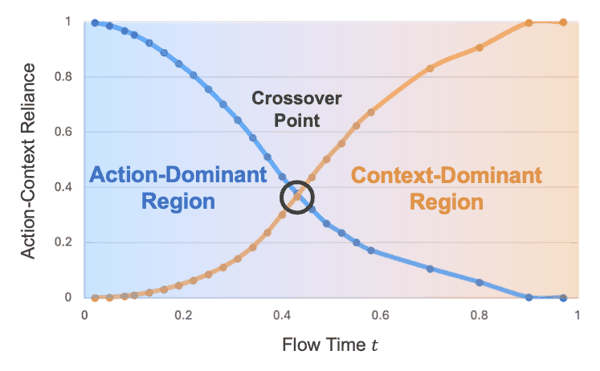 图 4 带噪动作 - 任务上下文的依赖分析。蓝色曲线代表 action 依赖性,橙色曲线代表 context 依赖性。 对于 任务匹配但精度不足 的数据,ε4P 利用其正确的任务上下文,将其准入高噪声区间,并通过 flow-time-conditioned classifier 判断高、低精度动作何时趋于难以区分,据此设定准入下界;对于 动作精确但任务不匹配 的数据,则利用其高质量动作监督,将其限制在低噪声区间,并根据模型对 action 与 context 的相对依赖确定准入上界。边界确定方法具体见图 5,前者主要反映数据的性质,后者取决于策略本身的信息依赖。图 6b、6c 进一步对 ε4P 确定的区间进行了全局和局部的验证。
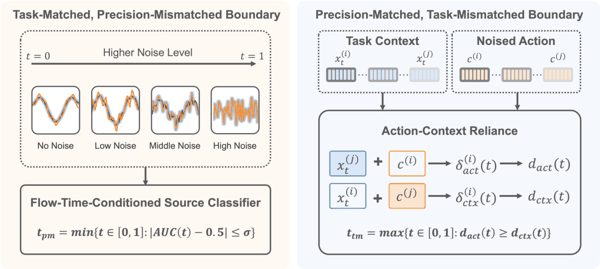 图 5 两类 不完美数据对应的边 界确定方法
ε4P 仅调整不同数据源的噪声采样范围:目标任务高精度数据覆盖完整区间,低精度目标任务数据用于高噪声区间,其他任务高精度数据用于低噪声区间;模型架构、flow-matching 目标及数据源采样概率均保持不变。
ε4P 的三个关键结论
1. 直接混训时越有害,不代表潜在价值越低
目标任务的低精度数据虽然在直接混训时带来更大损害,但经过 ε4P 的区间选择后,反而表现出高价值。这说明数据是否有用,不仅取决于其质量,也取决于它在训练中的使用位置。
2. 降低权重可以减轻损害,但未必释放价值
如图 6a 所示,降低 UMI 数据的 loss weight 虽能缓解性能下降,但所有非零权重均未超过仅使用高精度数据的 48.3%。与此同时,使用 ε4P 成功率达到 73.3%。这表明相比控制数据 “贡献多少”,更关键的是决定它 “在哪里贡献”。
3. 不完美数据可以替代部分高质量数据
团队进一步比较了 “新增等量高精度数据” 与 “新增等量不完美数据使用 ε4P” 的效果,在两类不完美数据和三个任务上,平均成功率仅下降 4.2 个百分点,意味着 ε4P 有望减少对高质量数据的依赖。