
用上曙光8000之后,这些科学家的心更“野”了
用上曙光8000之后,这些科学家的心更“野”了
最近,清华大学水利水电工程系河流与生态研究所副所长孙健,在“治黄”上的的“野心”越来越大了。他想构建一条米级网格的“数字黄河”,更精准地追踪黄河泥沙运动,给黄河治理更科学的数据支撑。
不止孙健如此——复旦大学类脑智能科学与技术研究院、大数据学院院长冯建峰想在计算机里1:1复刻人脑,人脑想多快,数字脑就算多快;中国农业大学农学院玉米生物育种全国重点实验室研究员赵海楠,想要构建一个数字化的“虚拟玉米”,让任何基因功能实验都能在其中完成;苏州国家实验室人工智能研究部主任研究员丁峰,想从原子尺度上深入理解材料构造过程……
以前,他们这些想法几乎是天方夜谭——既没有足够快的算力可以支撑(算得快),也没有足够精度的计算能力(算得准)。但如今,有了“曙光8000”做倚仗,一切开始不一样了。
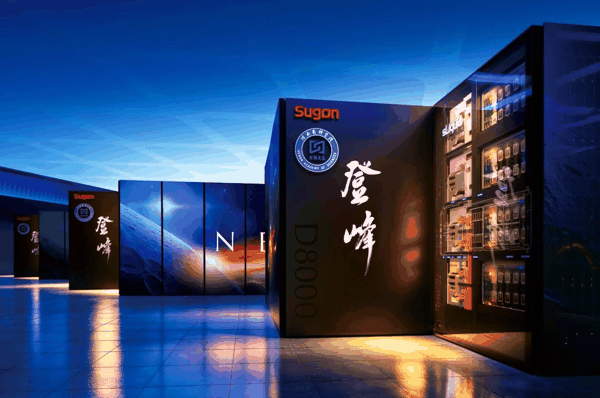
部署在国家超算互联网核心节点的曙光AI超集群 “登峰”(即曙光8000) 。图源:超算互联网
瓶颈
近期央视大型纪录片《超级工程》开播,首次将镜头转向超大规模算力基础设施——曙光8000。在第四集《向未来》中,记录了这群科学家如何借助这一国产算力巨兽,把“野心”变成可验证设想的故事。
“黄河的特点是水少沙多。水和沙之间的关系就特别复杂——水流影响泥沙,泥沙影响河床,河床又反过来影响水流。”孙健说,以前的模型因为计算力有限,几十米一个网格,“不能够模拟它们之间的关系”。
一个网格几十米,根本看不到水流中的漩涡等扰动,而它们对河床的影响却非常大。因此,孙健立下一个看似无法实现的目标:把黄河下游约800公里河道,全都做成一米级网格的“数字黄河”,给黄河做个“超级CT”。
而这,意味着巨大的计算量。曙光8000 AI超集群应用优化总负责人卜景德说:“它计算量非常非常大,十米级可能还算得动;到米级,(搁在以前)是不可想象的。”
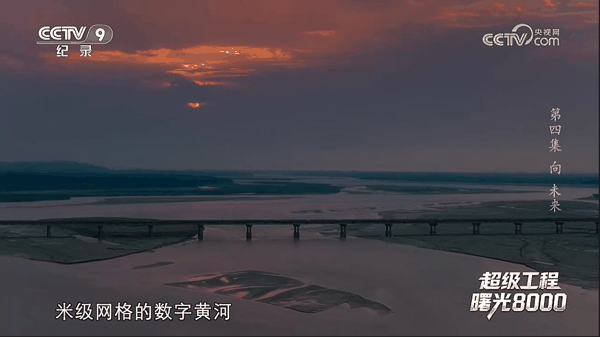
孙健希望在黄河下游构建“数字黄河”。 中科曙光供图,下同
冯建峰提出的问题更“烧脑”。
人脑仅重约1.4千克,却有860亿个神经元、超100万亿条神经连接,每20毫秒就会完成一次神经链路的动态重塑。它1秒的信息吞吐量,相当于国内三大通信运营商全网流量总和的33倍。
“八几年我就开始做神经网络,当时就很好奇,神经元到底怎么工作的?”带着心底这份好奇,冯建峰上下求索。2024年,他花费7年心血搭建出全球首个全人脑尺度的数字孪生脑。但是,这个数字孪生脑还不够灵光:人脑一秒内完成的思考、判断、感知与神经反应,它需要70秒。
这行不通。“(如果用它)做自动驾驶,我找不到车,(更)不知道开哪去了。”冯建峰说,他想要的,是一比一的全脑复刻。
“类脑有部分计算,90%甚至95%都是通信。”卜景德说,“它对整个(计算系统的)通信的要求是比较高的。”
类似地——构建可以做基因功能实验的“虚拟玉米”,赵海楠必须先过算力“规模关”和“稳定关”;丁峰想要模拟新材料原子间相互作用,要突破计算精度和效率等一系列问题……当科学家们研究的问题规模与复杂度跃升,他们对计算精度、效率和系统稳定性就提出了全新要求。
“超级工程”
央视纪录片将曙光8000定位为超级工程,在于它用十万张智能芯片,把海量计算资源真正组织了起来。
在它高密度的计算单元内,十万张芯片、一万多个计算节点、两三万个器件和超过10亿个零部件精密排布。随着系统规模扩大,这台“算力巨兽”的计算、通信、存储等规模和效率也上升到更高的数量级,它们共同让这十万卡在超大规模下高效协同,把硬件规模转化为真正可用的系统算力。
曙光8000的实力也很快得到检验。不久前,中国气象局地球系统数值预报中心与中科曙光依托曙光8000,实现1小时完成全球5公里分辨率、未来10天的预报计算。高分辨率数值预报需要在有限时间内处理海量数据、完成复杂计算,曙光8000的计算、通信、存储等系统能力经受住了考验。
主题:曙光8000