
谷歌开源「全模态六边形战士」!7.4亿参数,手机断网照样跑
(来源:AI信息Gap)
你手机相册里那几千张说好回头再看的照片,这回真有救了。
谷歌前几天开源了一个名为 EmbeddingGemma 2 的 全模态嵌入模型 。照片、截图、视频、录音,你打几个字描述一下,它就能在你手机或电脑本地帮你翻出来,全程不用联网。只搜索文字的话,它在手机上只占用 191MB 内存。网友,「比我微信缓存还小得多。」
我用中文实测了一轮。搜「6583」,它从一堆照片里翻出了那张写着取件码的快递截图。你敢信,它事先根本没把图里的字识别出来,全靠看图。接着我让它听中文语音找图,6 次只找对了 1 次。
EmbeddingGemma 2 眼睛很尖,中文耳朵还不太灵。
嵌入模型名气没有文本模型那么大,可搜索、推荐、AI 知识库(RAG)背后都得靠它。它干的活儿,是把一段内容变成一串数字,相当于在一张地图上给它标个坐标,语义相近的离得近,不相干的离得远。
以前这张地图基本只认识文字,图片得先配上文字说明,录音得先转成文字,才能到地图上去搜索。 EmbeddingGemma 2 把文字、代码、图片、视频、音频全都标在了同一张地图上。一张火烈鸟的照片、一段火烈鸟的视频、一段解释火烈鸟为什么是粉红色的文字,坐标邻近,你搜其中一个,另外两个也会被带出来。
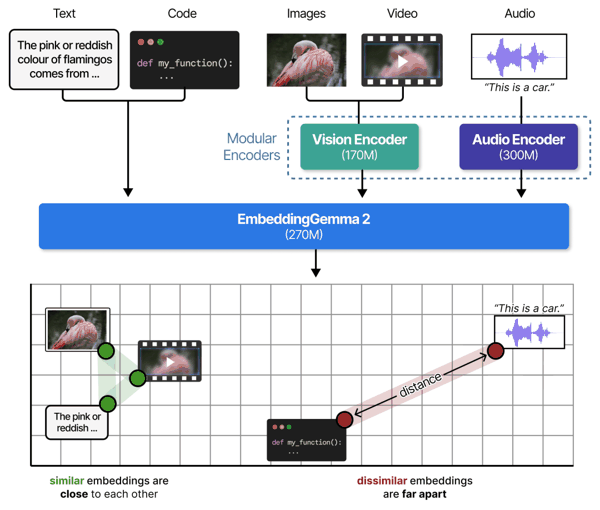 EmbeddingGemma 2 总计有 7.4 亿参数,可以拆分为三部分,文字部分 2.7 亿,看图看视频的视觉部分 1.7 亿,听声音的音频部分 3 亿,用不上的那部分参数可以不加载。所以,它量化后在谷歌 Pixel 11 Pro 手机上,只搜文字时仅占用 191MB 内存,三部分参数全部加载也才占用 567MB。
作为开源模型, EmbeddingGemma 2 的许可证是 Apache 2.0,可以放心拿去商用。谷歌官方称它和自家的 Gemini Embedding 嵌入模型底层用的是同一套技术。但 Gemini Embedding 只能调用谷歌的云端接口,用量大了要按量付费; EmbeddingGemma 2 能装进手机和电脑,算是一个完全免费的青春版。
EmbeddingGemma 2 和大香蕉 Nano Banana 2.1 同一天发布,网友吐槽,「除了 Gemini 4 Argon ,谷歌把能发布的都发布了。」
谷歌官方的演示全是英文,我更关心中文行不行。
我在一台 MacBook Pro 上把 EmbeddingGemma 2 跑了起来,没有独显,全靠 CPU。测试素材是 24 张照片,火锅、长城、熊猫、麻将、春联、早高峰的地铁,再加上我照着常见 App 样式制作的 8 张手机截图,高铁票、外卖单、快递取件码、体检报告、群聊记录。
用中文描述去搜照片,24 次测试有 23 次,第一个结果就是对的。口语它也轻松拿捏,12 句口语有 9 句一次过,搜索「我家主子在电脑上睡着了」,出来的是一只趴在键盘上的猫;「上次撸串」找到烤羊肉串,「早高峰」找到挤满人的地铁车厢。但 EmbeddingGemma 2 偶尔也会犯迷糊,把「国宝」认成了长城,「国粹」认成了舞狮,搜「加班写 bug」,第一名还是那只猫。毕竟只是个小模型。
搜索截图我发现 EmbeddingGemma 2 意外的强。8 张截图和 6 张照片混在一起,16 次搜索有 15 次第一个就对,搜「G1234」找到高铁票,搜「胆固醇偏高」找到体检报告,搜「香山爬山」找到了群聊截图。