
制造业企业选本体平台时,应该先想清楚的8件事
越来越多的制造企业发现,大模型能够理解提问,却未必了解企业内部的数据与业务关系。
文档检索 可以帮助回答资料查询问题。但 “ 这批原材料延期会影响哪些工单 ” 、 “ 这个零件变更会波及哪些客户订单 ” ,还需要跨系统的关系查询与业务规则。
本体( Ontology )因此进入采购讨论。市场上的产品也随之增多:图数据库、数据平台的语义层、本体建模工具,以及企业知识图谱平台。
它们覆盖的能力并不相同。对于 IT 部门,选型前应该想清楚以下 8 件事。
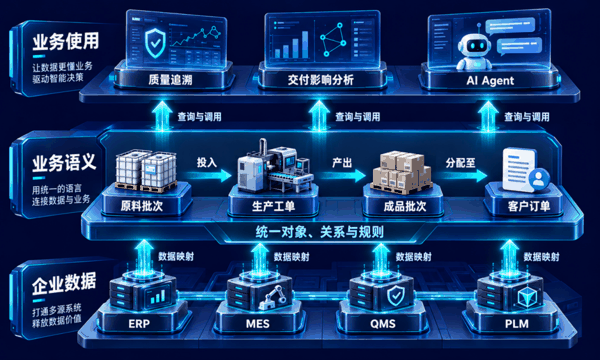 考量一:这个 “ 本体 ” 能表达什么?
很多产品都能定义对象、添加属性或展示关系图,但语义表达的深度存在差异。
元数据标签主要帮助识别和解释数据;业务对象模型描述对象与关系;形式化本体进一步表达类层次、公理和逻辑含义,为一致性检查与语义推理提供基础。
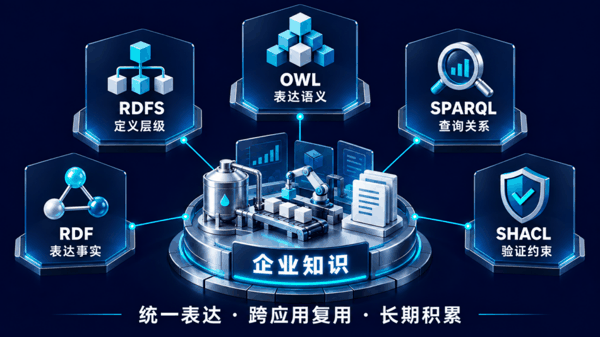
W3C 语义技术经过长期发展,形成了相互配合的标准体系: RDF 表达事实, RDFS 定义层级, OWL 表达形式化语义, SPARQL 查询关联数据, SHACL 验证数据约束。
对企业而言,开放标准的价值,是让多年梳理的业务概念、关系和规则拥有共同的表达基础,便于交换与复用。
因此,不能只看平台是否有 “ 本体 ” 功能,还要看标准支持到什么程度:能否编辑模型、执行查询、应用推理或约束,以及导出已有语义资产。
 考量二:本体建设的速度和门槛 —— 你有多少本体专家?
本体专家稀缺,企业很难依靠少数人从零定义所有对象,再逐一映射数据。
实际上, ERP 、 PLM 和 MES 已经包含大量业务结构:物料、供应商、零件、 BOM 、工单和批次,都可以成为初始模型的来源。
平台能够提取这些结构、辅助建立映射和识别跨系统对象,就能减少重复工作。 AI 也可以辅助字段匹配、关系发现和转换查询编写,由业务专家确认含义。
建设范围应围绕具体问题展开。先连接两个高价值数据域,解决一次质量追溯或交付影响分析,再逐步扩展。
真正影响建设效率的,是从数据接入到可用知识图谱的完整工作量,而不仅是模型画得多快。
考量三: 大规模 数据下的查询性能 —— Agent 会等多久?
工业数据 会随着生产持续积累。追溯一个原料批次,可能需要经过拆分、混料、返工和多级交付,再结合时间、状态及质量条件筛选。
Agent 还可能连续查询、验证假设并继续探索。如果一次任务串行执行 20 次查询,每次 30 秒,仅等待就需要 10 分钟。
内存 MPP 通过内存处理与多节点并行计算,为 大规模 关联分析提供支撑,并通过横向扩展承接增长的计算负载。
IT 部门需要结合典型多跳查询、并发调用和数据更新理解性能,同时关注扩展所需资源。同等规模的生产案例有参考价值,查询类型和运行条件也应一并说明。
考量四:数据是否需要移动? —— 治理和成本如何安排?
数据访问方式会影响查询性能、更新时效、源系统压力及运维成本。
物化图谱 将相关数据加载到图引擎,便于集中优化复杂查询,同时需要维护同步、存储与权限。
虚拟访问 通过映射查询源数据,减少预先复制,适合按需获取业务信息,其响应受到源系统、网络和跨源查询的影响。
混合方式 允许核心关系物化,其他信息按需访问。例如,使用批次谱系分析影响范围,再获取 ERP 中的订单状态。
关键在于平台能否根据数据特征组合访问方式,并明确更新延迟、源系统负载和治理责任。数据复制不必然破坏治理,虚拟访问也不意味着没有数据传输。