
NeurIPS 2026|不再依赖外挂:清华把「自我进化技能」训进Agent大脑
随着递归自我改进(Recursive Self-Improvement,RSI)研究的兴起,智能体的长期能力演进受到更多关注。技能(Skill)能够将交互经验提炼为可复用的操作流程与任务策略,使一次任务的收获服务于后续任务。让智能体学会自主创建和改进这些技能,为其持续进化提供了一条具体路径。
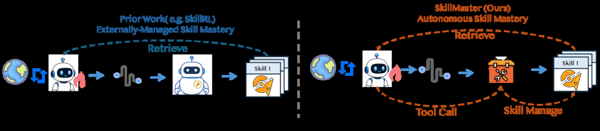 图 1 左:外部模块负责管理技能,智能体检索并使用技能。右:SkillMaster 将技能管理纳入智能体自身的策略,与任务执行共同学习。
然而,现有方法中的技能创建与更新,通常依赖外部教师模型、预设规则或辅助模块(图 1 左)。执行任务的智能体学会了使用技能,却很少被直接训练去改进技能。要沿着这条路径实现自主改进,还需要让 “如何进化技能” 成为智能体自身可以学习的能力(图 1 右)。
清华大学李勇教授团队提出了 SkillMaster,相关论文已被 NeurIPS 2026 录用,论文第一作者为北京中关村学院博士生杨敏。
研究以一个直观的洞察为出发点:有价值的技能改进,应当让原来失败的相似任务在后续更容易成功,让原来已经成功的任务以更少的步骤完成。SkillMaster 将这两类效果转化为技能编辑的学习信号,训练同一个智能体根据交互经验创建、更新和保留技能,使技能进化与任务执行共同进入强化学习过程。
 论文题目:SKILLMASTER: Toward Autonomous Skill Mastery in LLM Agents
Author: Min Yang, Jinghua Piao, Xu Xia, Xiaochong Lan, Jiaju Chen, Yongshun Gong, Yong Li
Affiliation: Shandong University, Zhongguancun Academy, Tsinghua University, Southeast University, University of Science and Technology of China
arXiv: https://arxiv.org/abs/2605.08693
GitHub: https://github.com/sduyangmin/Skill-Master
核心洞察:让失败的任务更容易成功
让成功的任务完成得更高效
要训练智能体改进技能,首先需要知道一次修改给后续任务带来了什么。仅用任务最终是否成功作为奖励,难以区分执行能力与技能质量,更难为某一次技能编辑提供明确的反馈。
为此,SkillMaster 关注技能修改对后续相关任务的实际影响。一条技能如果补上了已有知识的缺口,应当提高原先失败任务的成功机会;如果改进了已有的操作策略,应当让已经能够解决的任务减少不必要的步骤。这两种可观察的变化,为衡量技能修改的效果提供了依据。
方法框架:
联合学习任务执行与技能进化
要让智能体学会自主创建、修订和保留技能,需要解决三个问题:依据什么提出修改、如何评价修改的价值,以及如何联合优化任务执行与技能管理。SkillMaster 分别通过基于轨迹的技能审视、下游效用奖励和 DualAdv-GRPO 实现这三个环节
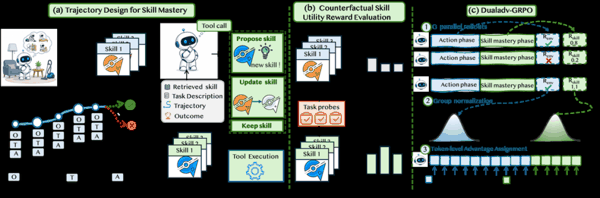 图 2 SkillMaster 的三个组成部分:基于轨迹的技能审视、反事实技能效用奖励,以及 DualAdv-GRPO 联合优化。
基于交互轨迹学习技能管理
技能审查阶段将任务目标、已检索技能、行动与观察轨迹、最终反馈一起提供给模型。模型通过 propose_skill、update_skill 和 keep_skill 三类工具调用,分别执行创建、更新和保留操作。例如,发现已有技能未覆盖某种搜索策略时,可以补充新技能;观察到实际反馈与已有操作规则冲突时,可以修订原有技能。
任务动作和技能工具调用由同一个策略生成,因此技能管理也直接纳入模型训练。SkillMaster 先通过监督微调,让模型具备基本的任务执行与工具调用能力,再利用技能效用反馈,通过强化学习优化创建、更新和保留技能的决策。
通过反事实对照评价技能效用
对于候选技能编辑,系统选取一组相关的探测任务,分别使用原始技能库与临时修改后的技能库执行,直接比较修改带来的下游变化。原先失败的任务是否转为成功、原先成功的任务是否减少执行步骤,都会体现在效用评分中,为技能编辑提供直接的训练反馈。
探测任务来自训练任务池,并依据任务类别、商品类别或问题语义相似度选择。系统综合考虑探测任务的平均得分变化,以及表现改善和退化的任务数量,计算效用奖励,并据此优化技能编辑决策。训练期间,效用奖励为正的修改才会写入持久技能库。
DualAdv-GRPO 联合优化两类决策
任务执行主要依赖环境结果反馈,技能管理则使用工具调用有效性和下游效用反馈,两类奖励具有不同的尺度与含义。为此,SkillMaster 提出 DualAdv-GRPO,分别计算任务执行与技能管理的优势,再分配给对应的生成内容,共同更新同一个策略。模型由此同时学习有效执行任务和改进可复用技能。
实验结果:
从任务表现到技能进化能力
实验基于 Qwen2.5-7B-Instruct,覆盖 ALFWorld、WebShop 和 SearchQA。其中,ALFWorld 包含六类模拟家庭任务,WebShop 考察多步商品搜索与购买,SearchQA 覆盖七个单跳和多跳问答数据集。