
刚刚,谷歌发布最强模型Gemini 4 Carbon!荣登榜首
编辑|冷猫
刚刚,Goog le 宣布推出 新一代前沿模型,号称「最强模型」的 Gemini 4 Carbon!
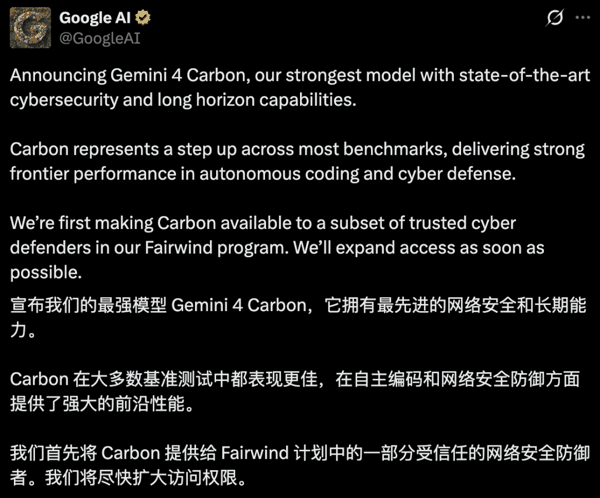
该模型 在网络安全和长程任务处理能力方面均达到了当前最先进水平 。Carbon 能够连续数天处理复杂任务,不会陷入停滞,也不会为了完成任务而走捷径,最终交付高质量、可靠的代码。
距离上一款旗舰 Gemini 4 Argon 发布,才过去两周。Demis Hassabis 用一个闪电 emoji 开头,谷歌正在「Iterating at lightning speed」(以闪电般的速度迭代)新模型。
很好,很有底气。从数据看,这个全新的 Carbon 模型真挺不赖。 Carbon 在第三方评测机构 Artificial Analysis 的智能指数 v5.0 中拿到 59 分,登顶 第一 。 紧随其后的 Claude Opus 5.5 是 58 分,GPT-6 Astra 是 57 分。三家模型只差 2 分,但「第一」就是第一。
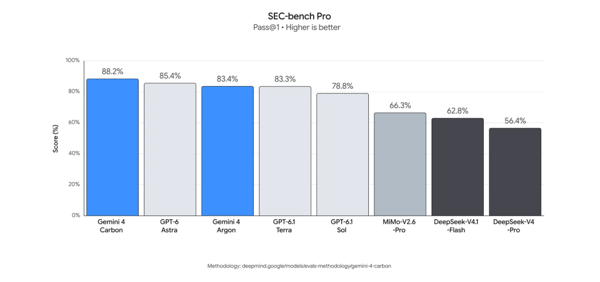
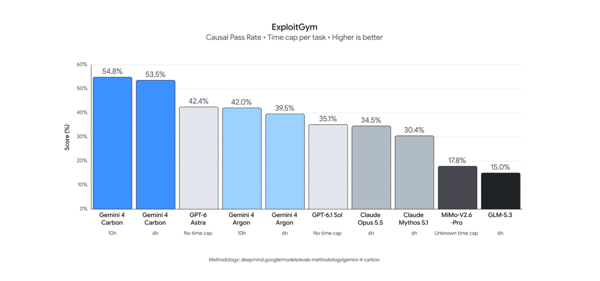
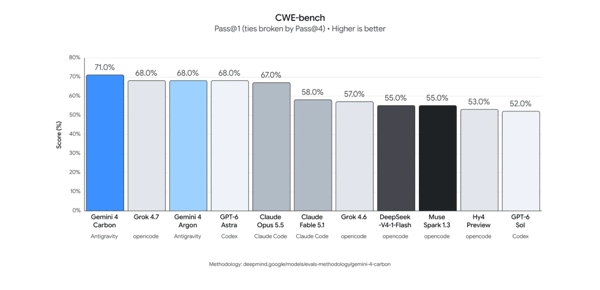
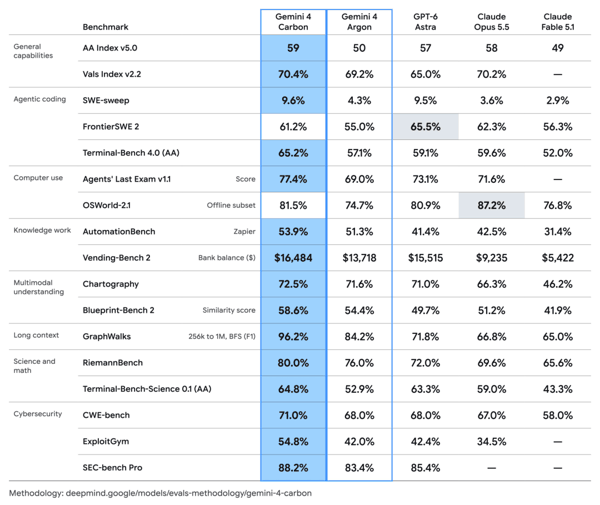 此外,Carbon 在漏洞发现基准 SEC-bench Pro 中取得 88.2% 的成绩,在漏洞利用基准 ExploitGym 中达到 54.8%,在漏洞修复基准 CWE-bench 中达到 71.0%,该模型均确立了明显的领先优势。
博客链接:https://blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-carbon/
网络安全全链路 SOTA,Chrome 团队实测「好 10 倍以上」
Google 在官方博客里为 Carbon 的网络安全能力花了大量篇幅。具体来看,Carbon 覆盖了网络安全防御的三个关键阶段,且每个阶段都做到了 SOTA。
寻找漏洞: 在 SEC-bench Pro 上,Carbon 拿下 88.2% 的成绩,超过 GPT-6 Astra 的 85.4% 和 Argon 的 83.4%。这个基准测试的任务是让模型自主发现隐藏在真实软件中的复杂安全漏洞。
验证漏洞: 在 ExploitGym 上,Carbon 得分 54.8%,大幅领先第二名 GPT-6 Astra 的 42.4%。这项测试衡量的是模型能否验证漏洞的实际可利用性,帮助安全团队决定修补优先级。在 10 小时时限下,Carbon 与 6 小时时限的差距很小(54.8% vs 53.5%),说明它在较短时间内就能完成大部分验证工作。
修复漏洞: 最终在识别出漏洞后,修复根源原因是网络安全防御生命周期中的一个关键步骤。Carbon 在 Collinear 的 CWE-bench 上达到了 71.0%,将验证后的发现直接转化为可工作的代码修复。
除了公开 benchmark,Google 还给出了内部数据。Carbon 生成安全代码的成功率比 Argon 提升超过 2 倍。Chrome 浏览器团队的反馈更夸张,他们报告 Carbon 在生成高质量安全补丁 方面比「另一 家实验室的大型前沿模型」表现好 10 倍以上 。
Google 旗下的云安全平台 Wiz 也参与了测试,观察到 Carbon 在 Web 渗透测试基准中表现领先,这是 Wiz「Scan for Good」计划的核心能力之一。
长程任务:可以连续运行数天
Carbon 的另一大亮点是「长程任务」能力。这也正在成为新一代前沿大模型竞争的关键能力之一。
Google 表示,内部团队观察到 Carbon 可以在大型代码库和底层系统中持续运行数天 ,完成跨文件的根因追溯(root-causing)与补丁生成。遇到死胡同时,模型能自主调整策略继续推进,不会直接终止任务。
这一能力的技术基础之一是长上下文处理能力的显著提升。在 GraphWalks 测试(256k 至 1M token 范围的 BFS F1 评测)中,Carbon 从 Argon 的 84.2% 跃升至 96.2%,领先 GPT-6 Astra 的 71.8% 和 Claude Opus 5.5 的 66.8% 超过 20 个百分点。支持 1M token 的上下文窗口,意味着模型可以一次性处理约 1500 页 A4 文档的等量信息。
长时程能力之所以越来越重要,背后是 Agent 工作流对模型提出了更高要求。 以软件工程为例,真正复杂的开发任务往往涉及持续跟踪代码变更、协调多个分支的修改、处理跨模块依赖,以及反复测试和修复问题。这些工作可能持续数小时甚至数天,早已超出单次问答的范畴。
对于前沿大模型而言,能否在漫长的执行过程中保持目标一致、及时纠错,并最终交付可靠结果,正在成为衡量其实际工程价值的重要标准。
Benchmark 全景:智能指数 9 项评测 4 个第一
Artificial Analysis 智能指数 v5.0 是目前业内引用较多的综合评估体系。
Carbon 以总分 59 登顶,在其中 4 项拿下单项第一 (HLE-Diamond、Terminal-Bench-Science、AA-Omniscience、AutomationBench-AA),比 Claude Opus 5.5(58 分)高 1 分,比 GPT-6 Astra(57 分)高 2 分,比两周前的 Argon(50 分)提升 9 分。Artificial Analysis 评价,Carbon 的领先由复杂推理、知识和科学任务上的强势表现驱动,在编程和知识工作方面有大幅进步(尤其相对 Gemini 系列历史表现),但在这些方向上还没有全面领先。
主题:模型|漏洞|网络安全|GPT-6Astra