
智能体AI时代,第六代骁龙8超级至尊版为何能重新定义旗舰
手机芯片如今正在经历一场身份的转变。
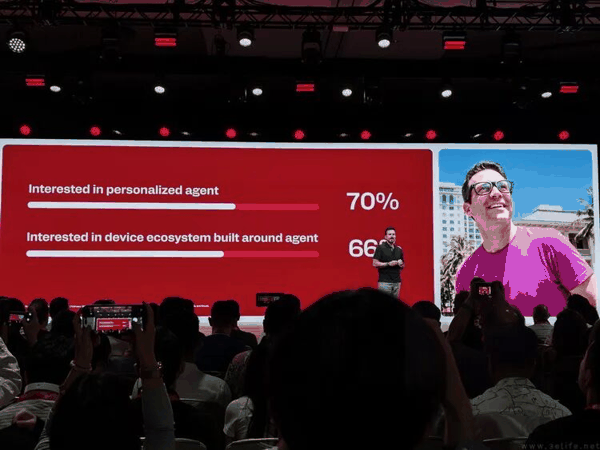
过去十年,旗舰SoC的竞争主线是算得更快,例如更高的主频、更多的核心、更强的图形渲染能力。但进入智能体AI时代,手机的运行方式变了,正如高通CEO安蒙所说,用户不再只是点击一个App,而是只用提出一个意图,此时手机就需要理解上下文、拆解任务、调用工具、跨应用协同,甚至代替用户来完成操作。
这种变化对芯片的要求,就不再只是单点性能的堆叠,而是一整套围绕智能、持续运行和低时延重新设计的架构。
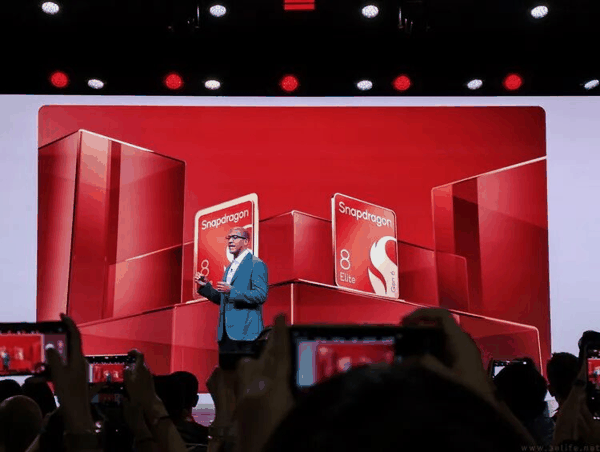
而这,正是高通新一代骁龙旗舰平台要回答的问题。在2026年的骁龙峰会上,高通首次在旗舰产品线同时推出两款产品,第六代骁龙8至尊版与第六代骁龙8超级至尊版。前者在旗舰级性能与先进智能能力之间实现了平衡,后者则专为最先进的AI工作负载和定义智能体时代的全新体验而打造。
这一代骁龙旗舰平台有三个关键词值得关注,分别是全球最快的移动CPU、全IP模块的AI加速,以及首次出现的双旗舰产品线。下面,我们就来为大家逐一解析。
最快的移动CPU:5GHz不是终点,低延迟才是关键
决定平台整体性能的关键,首先是CPU。新一代骁龙旗舰移动平台搭载的全新Oryon CPU,是首款最高主频达到5GHz的移动CPU,同时也是迄今为止的全球最快移动CPU。
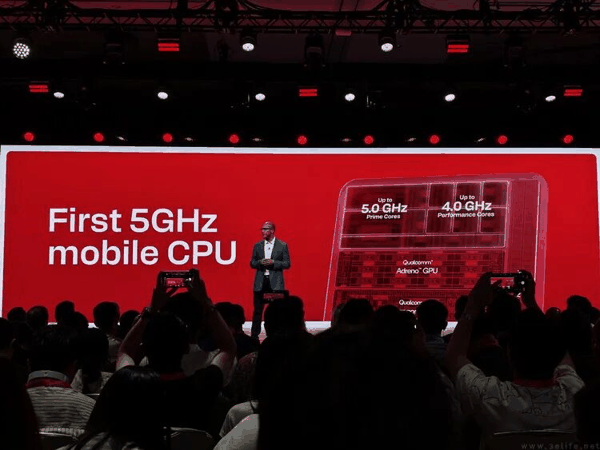
但5GHz这个数字,不能简单从字面上去理解。
时钟频率并不是实现更高CPU性能的唯一因素。芯片行业常说主频越高越好,但真正决定体验的,是主频与IPC(每时钟周期指令数)的组合。这就好比主频决定一秒能踩多少脚油门,IPC则决定每一脚油门能跑多远,两者相乘才是真实的速度。
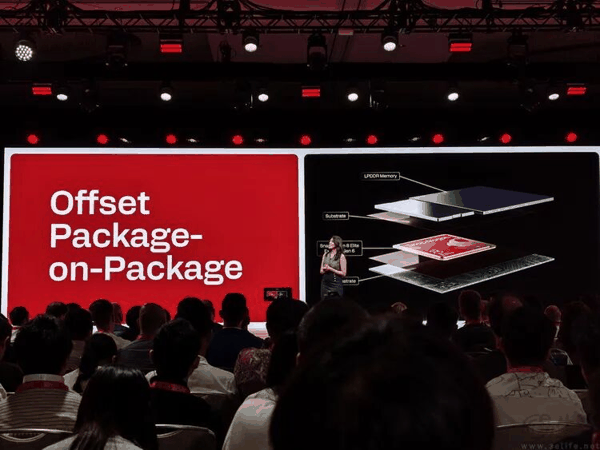
高通方面强调,5GHz的主频并非仅依靠先进制程就能实现,而是完整的定制化设计。这就包括了微架构、其背后的落地方案,以及CPU子系统,并且每个组件都经过精细调校。高主频与出色的IPC结合,性能优势才可以在实际应用中体现出来,例如应用在轻触瞬间打开、网页浏览更流畅、游戏和内容创作等高负载任务紧跟操作。
在这一代骁龙旗舰平台上,更值得关注的是缓存架构的变化。因为它解决的是“算得快”之外的另一个重要问题,也就是数据传输的延迟表现。
智能体需要规划任务、并调用各种工具,大型开放世界游戏需要加载海量资源,多任务场景可能需要同时保持十多个进程活跃。这些场景都涉及大量数据访问,一旦CPU无法快速获取所需的数据,再高的主频也会被“等数据”拖住。
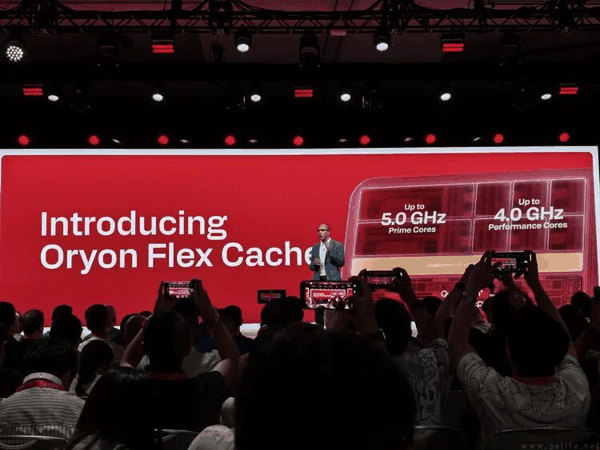
为此,高通方面引入了全新的缓存架构Qualcomm Oryon FlexCache。它是一套可扩展的缓存池,支持异构计算核心共享同一缓存空间,并根据工作负载动态调整资源分配。简单来说,就是过去每个核心各自为战,现在整个CPU像一个团队共用一个大仓库。
当高负载任务需要更强的算力时,超级内核可以充分利用整个缓存池。此时,更大的工作集能够驻留在缓存中,无需频繁回写至系统内存。这就意味着峰值性能可以持续释放,不会因任务负载超出缓存容量而迅速下降。
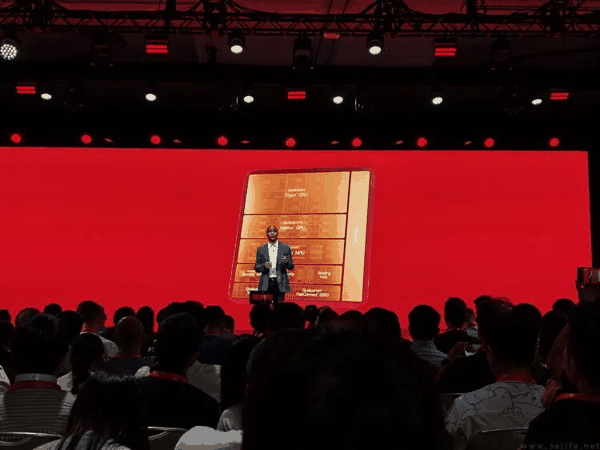
在当前整个行业面临内存大幅涨价的背景下,这项技术的意义也就尤为显著。因为它减少了核心访问系统内存的频率,就意味着即便手机内存没那么大、甚至内存频率没那么高,CPU受到的影响也会更小一些。
围绕游戏性能,高通再次交出完美的答卷
如果说CPU解决的是算力和数据获取,那么对游戏玩家来说,这一代骁龙旗舰平台最直观的升级则来自GPU,以及它背后的连接系统。
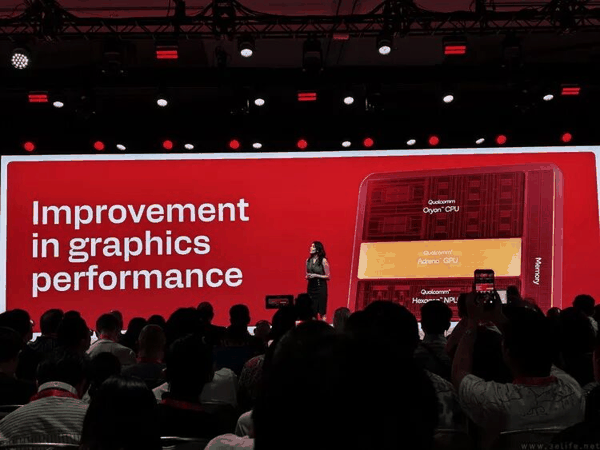
首先,新一代Adreno GPU在图形性能与能效方面都实现了代际跃升。基于三切片架构带来的性能与能效提升,每个切片的频率提升了250MHz,以更高的主频带来了更强的渲染能力。
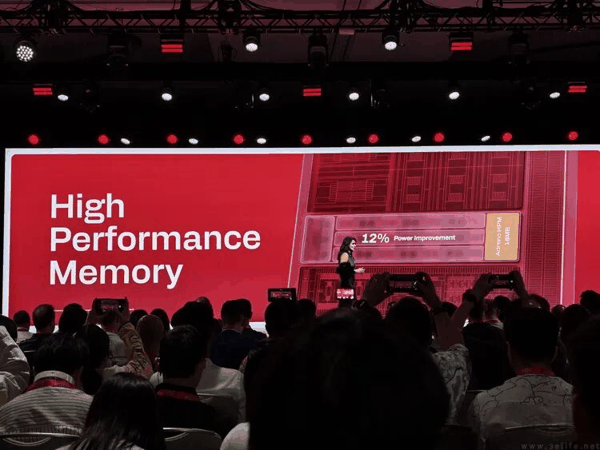
与频率提升配套的,则是显存架构的进化。新一代骁龙旗舰平台配备了18MB Adreno独立高速显存(HPM),而这是一种专用的片上图形存储器。HPM可以让内存更靠近图形IP模块,减少GPU对系统内存带宽的争抢。更少的数据传输就意味着更低的时延、更高的能效和更持久的游戏体验。高通方面公布的相关数据显示,借助这一技术,新平台实现了12%的功耗降低。
这一代Adreno GPU最为关键的改变,是首次引入了Adreno Matrix Cores。
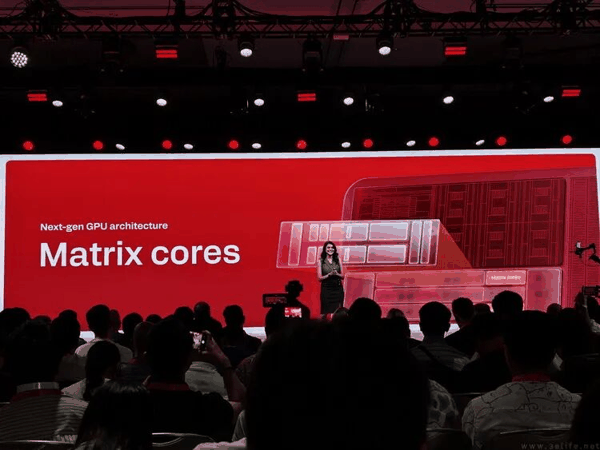
作为面向AI负载打造的GPU专用核心,Matrix Cores专为在图形管线内直接运行AI模型而设计。这不仅是Adreno发展历程中的突破,也意味着从NPU、CPU到GPU,骁龙平台的每个核心引擎都已经获得了Matrix加速能力的加持。
Matrix Cores带来的直接成果,就是Adreno Neural Fusion。这是一项由AI驱动的渲染技术。它将神经网络处理、AI超级分辨率(超分)和AI帧生成整合进统一的图形管线。
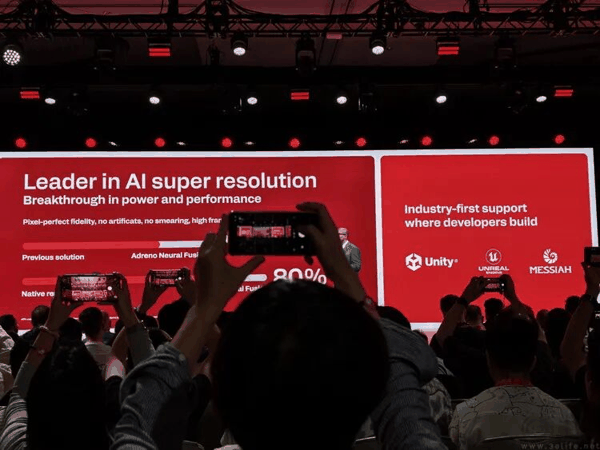
那么这意味着什么呢?简单来说,过去游戏的“超帧超分”通常需要帧数据先从GPU传输到NPU或外挂的显示增强芯片,再由它们进行后处理。可现在,游戏画面不用离开GPU,AI画面增强在图形处理的源头即可运行。
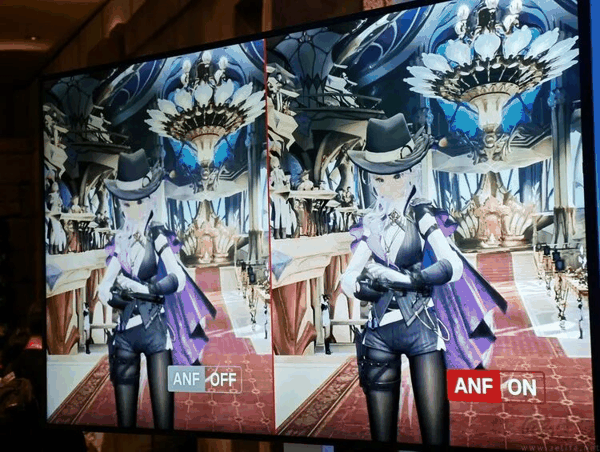
对于玩家来说,这就意味着开启超分超帧后,不会再有显著的操作延,也不再有可察觉的画面细节抖动、快速移动物体出现伪影等问题。Adreno Neural Fusion在提供卓越画质的同时,能大幅减少伪影、提升帧率稳定性,并持续呈现清晰锐利的细节。同时因为少了数据搬运这一过程、也不再需要“外挂”额外的芯片,使得游戏可以在维持峰值性能的同时,还能延长续航、保持稳定的高帧率。
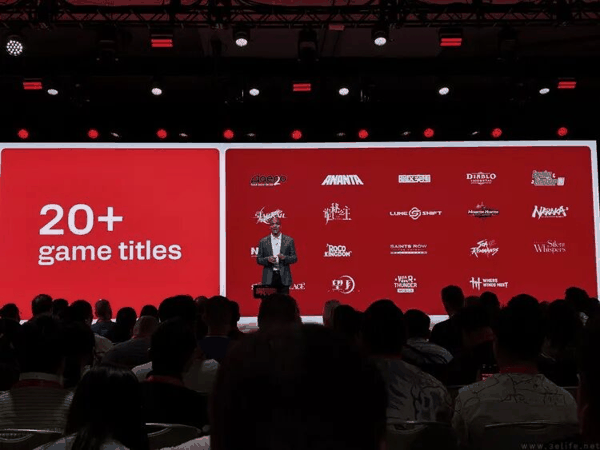
更重要的是,兼容性还更好了。高通方面公布的信息显示,Adreno Neural Fusion是行业首个已商用、支持主流游戏引擎的移动端AI超级分辨率技术,并已支持Unity与Unreal引擎。因此游戏开发者无需开发自定义解决方案,即可获得开箱即用的画质与性能提升。目前,这一技术已经得到了至少18款手游的支持,未来还将快速扩大兼容列表。
全IP AI加速:为智能体AI而生的平台级能力
这一代骁龙旗舰平台与前代最本质的区别,或许不是任何一个单项参数,而是一个结构性的变化:AI加速不再是某个模块的专属能力,而是覆盖CPU、NPU、GPU乃至传感器中枢的平台级能力。
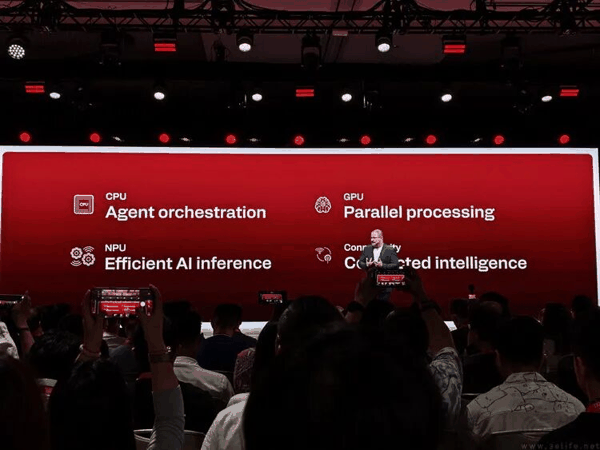
要理解这一点,就需要先弄明白智能体AI的运行方式。事实上,智能体并不是执行单一任务,而是管理一连串任务,包括理解用户意图、记住上下文、规划步骤、调用工具、执行操作,并随着用户的习惯不断学习。这种工作负载有三个特点,分别是持续运行、多模态、低时延,要求芯片的不同部分在恰当的时机承担恰当的角色。
在新一代骁龙旗舰平台上,每个IP模块的分工清晰、且明确。
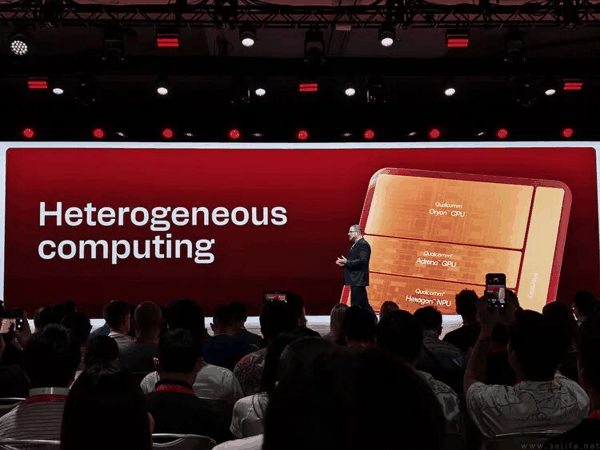
首先是CPU,它是智能体的大脑与调度中枢。Oryon CPU负责指挥、规划、推理,并协调整个工作流程。如果任务需要调用云端API,就能快速调度路由。FlexCache则确保智能体在高负载任务与核心间迁移时,数据始终触手可及,不会降低响应速度。
其次是NPU,这也是智能体的算力引擎。此次,新一代Hexagon NPU也引入了两项关键创新。
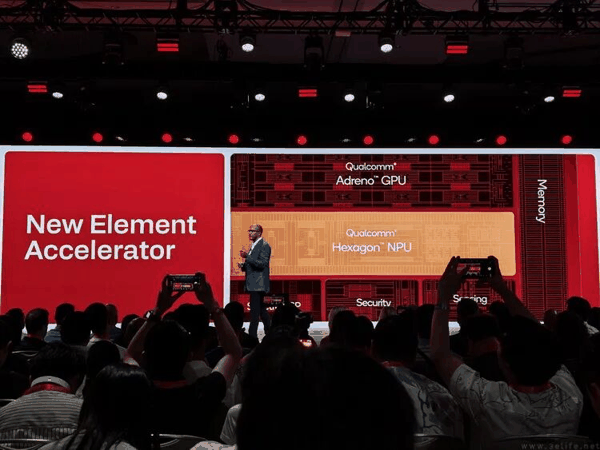
其一,是全新的Element Accelerator,它专为赋能智能体AI的Transformer工作负载打造。通过结合向量计算单元与标量计算单元,其可以加速大模型中最关键的运算,帮助智能体更快响应、更高效地推理。
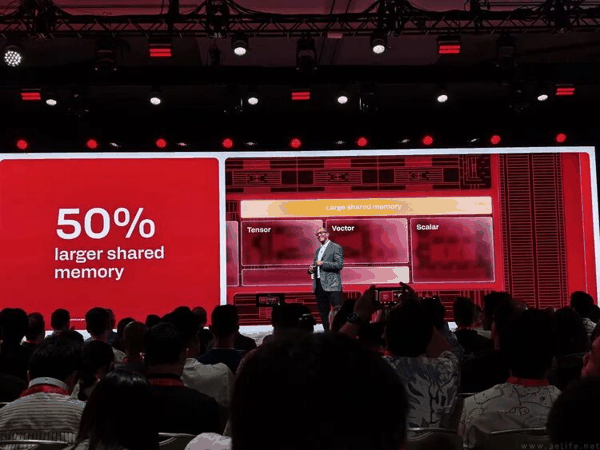
其次,是NPU内部的大容量共享内存扩容了50%。这就能将更多上下文与KV缓存数据保留在NPU内部,减少NPU访问外部内存的次数,既降低时延,也为其他工作负载释放了内存带宽。
而在GPU内部,前文中提及的Adreno Matrix Cores除了服务图形渲染外,还可用于通用AI计算负载,这就使得AI能力因此同时存在端侧推理与图形处理这两条路径。
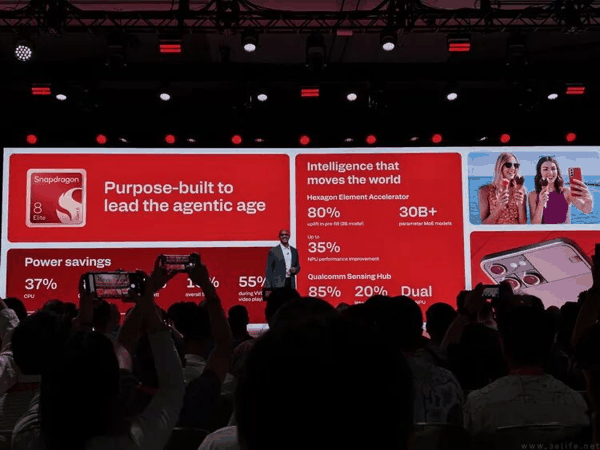
最后,新一代骁龙旗舰平台还带来了全新的高通传感器中枢。它内含两个Micro NPU,性能提升高达85%,能效提升也达到20%,可支持2亿参数规模的模型。即便在SoC其余模块空闲时,传感器中枢也会始终保持环境语音感知。配合升级的个人记录(Personal Scribe)功能,手机就可以持续构建个人上下文层,从用户选择保留的信息、参与的对话和关注的重要内容中不断进行学习。
将这些新技术放在一起,就得到了智能体AI在全新骁龙旗舰平台上的完整工作流。环境语音被传感器中枢持续感知,意图被Oryon CPU理解并规划,任务被调度到合适的引擎,需要Transformer推理时交给Hexagon NPU,需要在图形管线内运行时交给Adreno GPU,需要云端能力时则由CPU快速路由。当每个模块各司其职,AI处理就成为了平台级能力,而不是附加在某个模块上的功能。
同时推出两款旗舰,重要的是毫不糊弄
这一代骁龙旗舰平台在产品策略上还有一个值得注意的变化,那就是高通首次在旗舰产品线同时推出了两款骁龙8至尊版平台。