
离谱!花一样的钱Claude额度却不一样?Anthropic被曝秘密测试订阅套餐
你敢信,花一样的钱订阅 Cla ude,你拿到的额度却可能比别人少了 20%。
根据研究机构 SemiAnalysis 的最新披露, Anthropic 正在对 Claude 订阅额度进行 A/B 测试,部分相同套餐的用户,被分配了不同的额度设置。
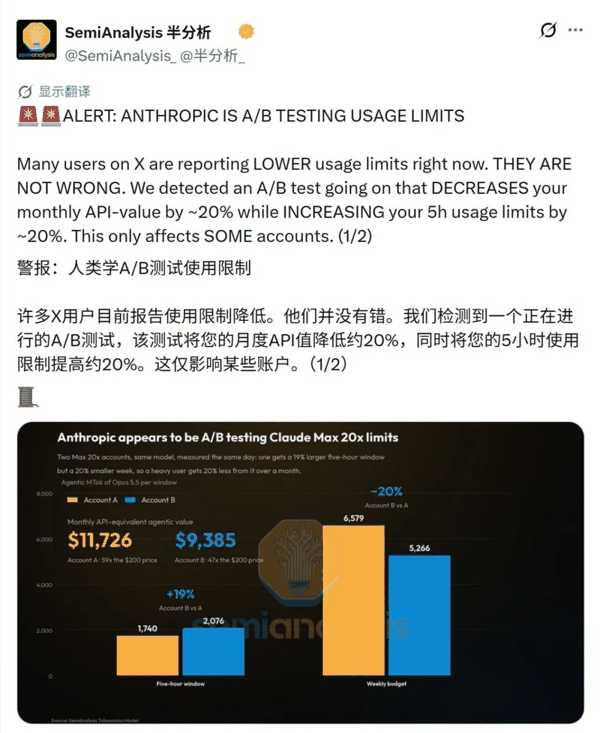 测试中,部分账号的五小时使用额度被提高了 20%。
听上去似乎是好事,但 SemiAnalysis 发现, 这部分账号按 API 价格折算,月度可用资源的价值反而降低了约 20%。
怎么回事,难道真的「鱼越多鱼越少」?
Claude 额度越来越不够用了?
最近,很多用户反映,Claude 的额度越来越不够用。
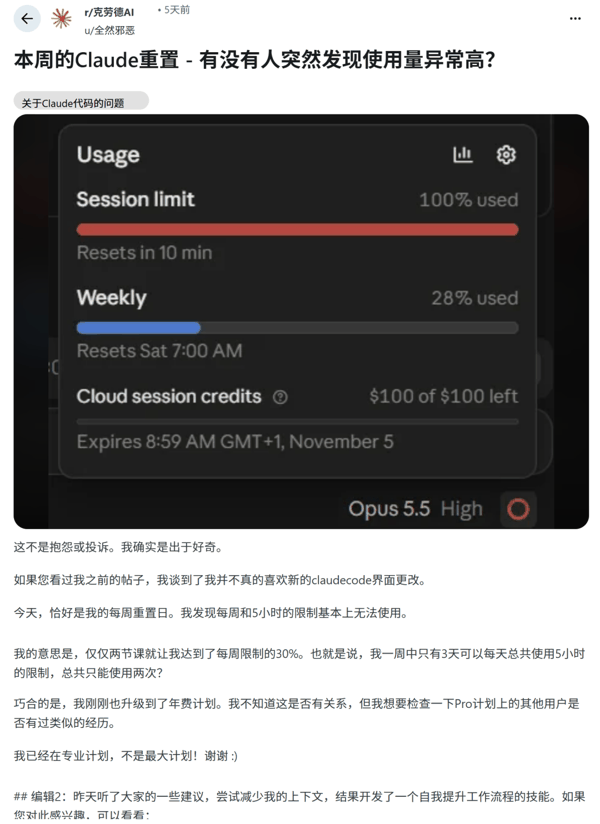
在 Reddit 的 ClaudeCode 社区,一位用户抱怨,自己原本可以用上四五天、甚至一周的额度,如今仅仅 24 小时就快要耗尽。
还有用户表示, 刚刚重置的额度,只进行几次高强度操作,就已经消耗了相当大一部分。
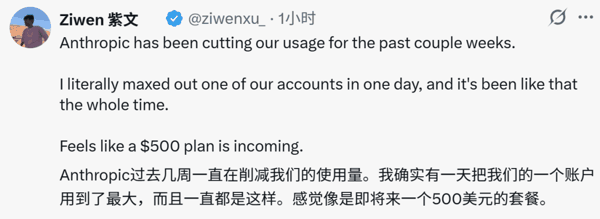
X 用户也有类似的遭遇,有人认为过去几周 Anthropic 一直在削减额度,甚至大胆预言了「500 美元」的新套餐。
 实际上,Anthropic 近期确实频繁地调整 Claude 的额度,调整结果有增有减。
今年 5 月至 9 月,Anthropic 曾开展限时活动,将 Claude Code 的每周使用额度提高 50%。
但从 9 月 14 日起,这项活动结束,新的标准额度虽有提高,但换算下来,用户实际拿到的比活动期间减少了约 17%。
紧接着,9 月 22 日,Anthropic 发布 Claude Opus 5.5,又宣布提高 Pro、Max、Team 等套餐的 5 小时使用额度。按照 SemiAnalysis 当时的实测,使用 Opus 5.5 时,Max 套餐可用 token 数量增加约 20%,Pro 套餐则增加约 50%。
由于模型和推理强度不同,不同时期的相同订阅额度在使用体验上大不相同。同时,5 小时额度和每周额度也并不遵循同一套限制规则。这些都可能导致用户对额度的使用体验忽高忽低。
而 SemiAnalysis 最近披露的测试,则揭示了除上述因素之外的可能性: 即便购买相同套餐,不同账号的额度设置也可能存在差异。
Claude 的使用额度,究竟是怎么测出来的?
用户感受到额度缩水,但 Claude 的使用上限究竟是多少,又是如何变化的?
从进度条反推出真实的 Token 额度
SemiAnalysis 在 10 月 5 日发布的长篇报告中,把这套不透明的额度规则当成了一个可以反向测量的问题。
研究人员先将 Token 分成四类: 普通输入、缓存写入、缓存读取和模型输出, 再设计实验,让 每次请求尽量只消耗其中一种。
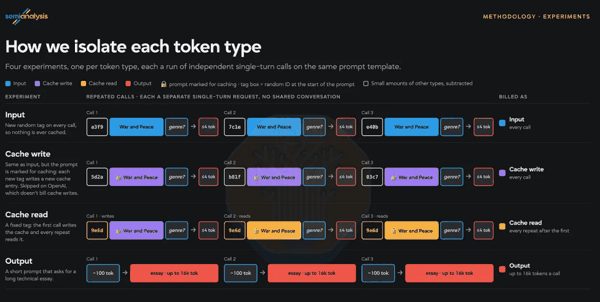 他们拿《战争与和平》的长文本测试输入,给每次请求加上随机标记,防止命中缓存;测量缓存写入时启用缓存并更换标记,测量缓存读取时则固定标记,让后续请求反复读取同一段内容。至于输出,他们使用技术文章引导模型持续生成长文本。
接下来,就是反复发送请求,并同时记录实际消耗的各类 Token 数量和额度进度条的变化。
由于进度条并非实时连续变化,研究人员通过多次请求累计数据,将测量误差控制在 ±5% 以内。例如,100 万 Token 消耗了 5% 的额度,就能推算出该窗口约有 2000 万 Token 的容量。
订阅额度背后,是一笔昂贵的算力账
测出实际额度后,SemiAnalysis 还要解决一个问题:这些 Token 究竟值多少钱?
这里需要考虑不同 Token 的使用比例。报告发现,在其测试的编码智能体工作负载中,约 96.5% 的 Token 来自缓存读取。智能体执行任务时会反复调用模型、复用上下文,而缓存读取的 API 价格远低于普通输入,不同服务商的额度扣减规则也有所不同。
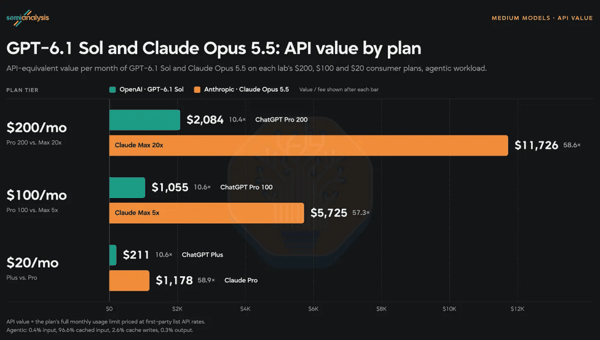
因此,SemiAnalysis 根据实际智能体任务中各类 Token 的使用比例,结合 API 定价,估算出订阅套餐的「API 等价价值」:如果通过 API 购买同等用量,需要花多少钱。
结果发现,Claude 的订阅套餐相当划算。 在特定智能体工作负载下,Claude Opus 5.5 订阅的 API 等价价值,约为 OpenAI 同价位套餐的五倍。
 对用户来说,这意味着相同月费能够换来更多可用资源。但对 Anthropic 而言,大量重度订阅用户也带来了高昂的算力开销。SemiAnalysis 估算,订阅业务仅贡献 Anthropic 约 10% 的收入,却消耗了约 42% 的推理算力。
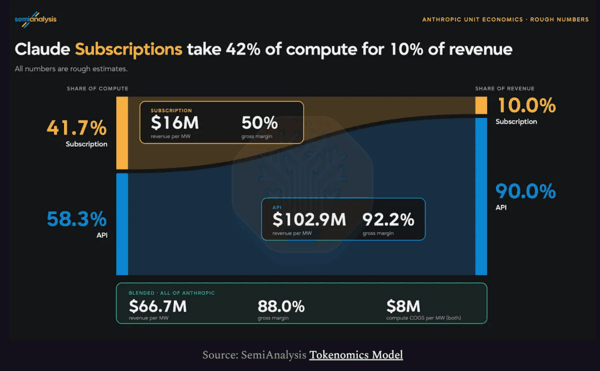 这种收入与算力消耗之间的落差,也让订阅额度的分配成为一道难题。对此,OpenAI 和 Anthropic 选择了不同的调整方式。
OpenAI 选择直接削减额度,其每月 200 美元套餐的 Token 上限被削减约一半,新订阅用户立即受到影响,老用户则可沿用原额度至 10 月 29 日。
Anthropic 的调整则更加渐进:同一套餐内,模型越高端,能够获得的 API 等价价值通常越低,从 Opus 5.5 到更高端的 Fable 5.1,这种差距尤为明显。此外,Opus 5.5 降低 API 价格时,Anthropic 虽然提高了 Max 和 Pro 套餐的 Token 额度,但增幅仍不足以完全抵消降价带来的等价价值变化。
两种策略最终都指向同一个目标:减少重度用户获得的算力补贴,改善订阅业务的利润空间。
五小时额度增加,为什么每月反而能用得更少?
再看 SemiAnalysis 最新公布的两个 Claude Max 20x 账号测试结果,就能理解这种额度调整的效果。
在相同模型、相同智能体工作负载下,账号 B 的五小时额度比账号 A 高约 19%,每周额度却少约 20%;每月 API 等价价值也由 11726 美元降至 9385 美元。
五小时窗口更宽松,可以让用户在一次连续工作中处理更多任务。但对于每天高频调用 Claude 的重度用户,真正限制一个月使用总量的,仍然是更严格的每周上限。
这也揭示了此次 A/B 测试最值得关注的地方: Anthropic 调整的不只是额度大小,还有算力在不同时 间 窗口里的分配方式。 对偶尔集中使用的用户和每天持续运行智能体的开发者来说,同一次调整可能带来截然不同的体验。
账单照收,收据不给?
Claude 的额度成了一笔糊涂账
消息传开后,评论区的争议主要集中在两点。
一是 Anthropic 在用户不知情的情况下,对相同套餐的账号进行不同额度的测试, 付费套餐的透明度遭到质疑 。
二是这次测试看似提高了 5 小时使用额度,却降低了每周的限额,这激起不少用户不满,因为 所谓的「额度优化」只是换一种方式掏用户口袋 。
X 用户 alice 提到了一个容易被忽略的细节:Claude 的 5 小时限制容易让用户高估套餐的实际使用量,并指出, Max 20x 在每周限额下,实际体验可能和 Max 10 差不多,只有在 5 小时窗口内才能体现完整的 20 倍差距。
主题:用户