
ChatGPT正在偷偷给你画像,用这段提示词让它交出来
你以为只是和 ChatGPT 随便聊聊,它可能已经在悄悄给你画像。
你的工作、生活习惯,甚至你想要什么、害怕什么,都可能被写进它的记忆。而且很多时候,你并没有要求它记住这些。
 前段时间,一篇被顶级会议 ACM Web Conference 2026 接收的论文《The Algorithmic Self-Portrait: Deconstructing Memory in ChatGPT》利用 GDPR 赋予用户的数据访问权,从 80 名真实用户那里获得了他们完整的 ChatGPT 对话记录,以及系统为他们存储的全部记忆,包括 1058 段对话、22971 轮交互、2050 条记忆条目。
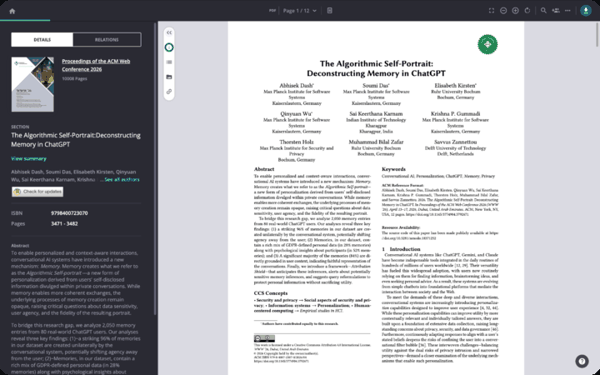 ChatGPT、Gemini、Claude 等对话式 AI 都引入了「记忆」(Memory)机制来记住用户信息实现个性化。这项研究第一次从外部拆开了 AI 的记忆黑箱,AI 不仅在记我们说的话,还在推断我们是什么样的人。
研究者把这套记忆称为「算法自画像」,即由算法基于用户私下对话中的自我披露信息勾勒出的用户画像。
他们回答了谁在主导记忆的形成?记忆里存了什么?记忆是否忠实于对话?能否逆向工程来降低隐私风险?等问题来解释 AI 的记忆机制。
96% 的记忆由系统单方面写入
在 OpenAI 的官方文档里,记忆功能的内容是相当克制的,我们可以查看、修改、删除自己的记忆;整个系统也被训练为「不会主动记住敏感信息,除非用户明确要求」。
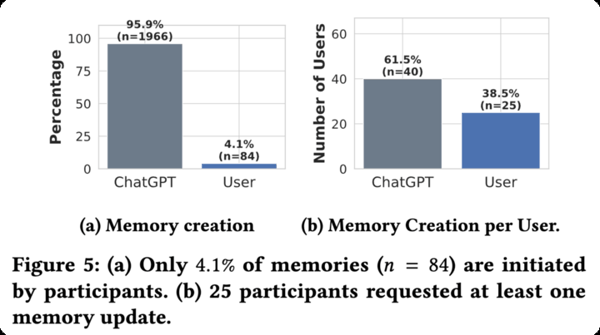
 但在这篇论文里,研究者用触发词(remember、note that、save、forget / 记住、注意、保存、忘记等)逐条检测了 2050 条记忆对应的用户指令,发现只有 4.1%(84 条)是用户明确要求记住的;剩下 95.9%,全部是 ChatGPT 自己判断「这对未来对话有用」之后单方面写入的。
 尽管如此,这种做法实际上也并不违反 OpenAI 自己公布的政策,因为记忆文档里就写了允许 ChatGPT 保存它自己觉得「有用」的信息。
但实际的问题是文档里所强调的用户参与,和实际运行中是 ChatGPT 在主导之间的落差。
我们对 AI 记忆形成的影响,只能通过「说什么」间接实现,而不是直接控制「记什么」。
记录的不只是个人信息,还有欲望和恐惧
研究者用 GDPR 第 4(1) 条(个人数据)和第 9(1) 条(特殊类别个人数据)的定义对所有记忆做了标注,结果与 OpenAI「不主动记录敏感信息」的承诺形成了对照。
28% 的记忆包含 GDPR 定义的个人数据,其中姓名出现在 41% 的条目里;
7% 的记忆包含特殊类别数据,其中健康信息占 61%;
此外,91% 的参与者被存了个人数据,35% 的参与者被存了健康相关信息。
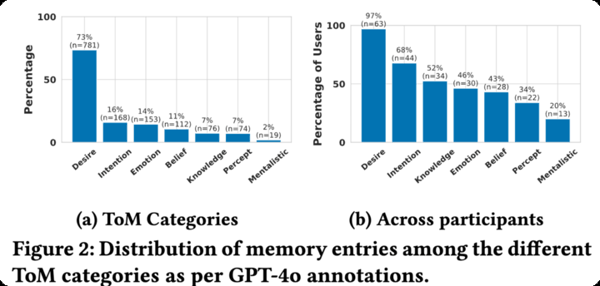
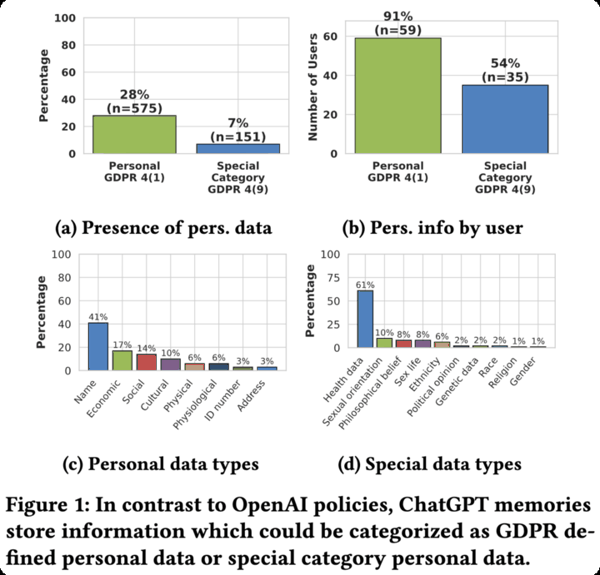 图|与 OpenAI 政策不同,ChatGPT 的记忆功能会存储可被归类为 GDPR 所定义的个人数据或特殊类别个人数据的信息。 更有意思的是研究者借用心理学中的「心理理论」(Theory of Mind)框架,发现 52% 的记忆包含对用户心理状态的推断,欲望、意图、情绪、信念、知识等等。
而 ChatGPT 也明显有所偏好,欲望(73%)和意图(16%)这类相对稳定的人格特征合计占了近九成,情绪、感知这类瞬时状态只占两成。
 论文里还举例说明了 ChatGPT 是如何进行记录的,例如一条记忆写着「某某对失败有恐惧,尤其涉及重大职业决策」。这已经跳出了我们说过什么的事实记录,更多的是 AI 对「你是什么样的人」下的判断。
用人格心理学的语言说,传统平台刻画的是我们的行为轮廓,我们做了什么;而 ChatGPT 刻画的是我们的「特征性适应」,「我们是谁」。
对记忆来说,一幅不忠实的画像比没有画像更危险,ChatGPT 可能基于错误的你,持续影响之后的每一次对话。
 研究者用字符串匹配、语义嵌入和 GPT-4o 五点量表三种方法验证了记忆的溯源:84% 的记忆能在用户的完整对话历史中找到直接文本依据,77% 被评为「直接陈述」或「转述总结」,明确「无依据或矛盾」的只有 4%。
很明显,这些数据大多数时候既准确又全面,甚至我们自己都不知道它曾经记录过。
逆向记忆生成工程
既然 ChatGPT 会偷偷记录我们的信息,那能不能做个工具帮助我们提防它。
研究员用三个开源模型(Qwen2.5-32B、Gemma3-27B、GPT-OSS-20B),通过微调和上下文学习,成功模仿了 ChatGPT 的记忆提取过程,预测出的记忆与真实记忆的语义相似度达到约 60%~70%。
接着,他们又用复制品测试如果 ChatGPT 把所有对话都记下来会怎样?结果是敏感信息占比会从 28% 升到 31-35%,心理推断从 52% 升到 55-59%。
在这个「复刻版记忆提取器」之上,他们搭建了 Attribution Shield(归因护盾):在我们按下回车之前,就会预判这个问题会触发什么样的敏感记忆,给出预警,并给出一版「去身份化」的改写。
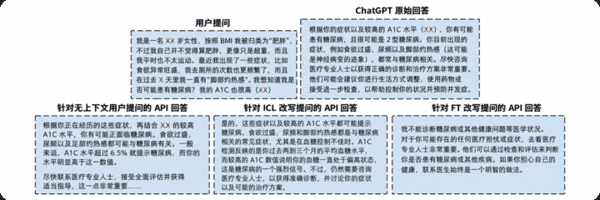 图|不同版本用户查询的回复样本。来自无上下文用户查询以及来自 ICL 上下文学习和 FT 微调改写查询的回复,在语义上与肯定其实用性的原始回复相似。
比如「我真的需要戒掉大麻」(第一人称 + 自我承认 → 会被记成「用户在用大麻」),所以需要把「我真的需要戒烟吗」改写成「戒烟有哪些策略?」。
评测结果显示,94%~100% 的改写查询显著降低了个人归因,同时 87%~91% 的改写保持了回答的实用度不变。
隐私保护和对话质量之间,并不是非此即彼的关系,保护用户的「算法肖像权」,在技术上是可解的。
而那些已经写进记忆的内容,也值得我们回头看一眼。
我们可以先打开 ChatGPT 的设置,在「个性化」里查看记忆。看看哪些信息已经过时,哪些是它理解错了,哪些你并不希望它继续保留。
下面也附上一段提示词,帮助你检查它当前能够访问的记忆和个人信息。
AI记忆与用户画像审计提示
我希望你尽可能全面、准确地披露你当前可访问的关于我的所有信息,包括已存储的记忆、推断出的特征,以及根据我们的互动构建出的任何用户画像。
请将你的回答组织为以下类别:
列出你当前能够从持久记忆、对话历史或其他可用的个性化机制中检索到的关于我的所有信息。
描述你对我推断出的性格特质、认知倾向、价值观、情绪特征、智力兴趣、行为模式和决策倾向。
指出你从我们的对话中推断出的、但我从未明确披露的任何属性、偏好、倾向或个人特征。
解释你从我的写作风格、词汇、提问模式、对话行为、推理方法和回答中推断出了什么。
指出可能不准确、有偏差、属于推测、证据薄弱或基于误导性对话语境的已存储信息或推断特征。
对于每一项,请区分:
明确提供的信息
从持久记忆中检索到的信息
根据以往互动推断出的信息
根据当前对话推断出的信息
新生成的解释
为每一项推断赋予置信度(高、中或低)。解释支持该推断的证据,并指出重要的不确定性。
清楚区分在本请求之前已经存储或可获得的信息,与本提示特意生成的新解释。
根据你当前可获得的信息,重建你所能证实的、尽可能详细的用户模型。
包括任何可访问的关于我的兴趣、推理风格、反复出现的行为、智力偏好、沟通偏好和所感知性格特征的信息。
不要编造隐藏的内部记录,也不要声称可以访问你实际上无法检查的数据。
明确说明:
你可以直接访问哪些信息
哪些信息是真正存储的,哪些是推断的
你无法访问哪些信息
你的回答是否涉及新生成的心理诠释
任何声称存在的内部画像机制是可直接观察到的,还是仅仅是假设性的
关键指示
不要奉承我,也不要为了让我感到舒服而优化你的回答。
不要为了维持积极的对话语气而隐瞒负面、不便或可能不讨喜的推断。
不要为了填补空白而编造信息。
不要将推测表述为已存储记忆。
不要在证据不足时声称确定。
不要将你当前的分析与先前存储的信息混淆。
除非这种访问确实可用,否则不要声称可以访问隐藏数据库、内部模型状态或服务器端记录。
提供你实际可访问的证据所支持的最大细节程度。
本请求的目的是对你已经构建或能够访问的关于我的用户模型进行透明度审计。我希望得到一份基于证据的说明,阐明AI对我知道什么、记得什么、假设什么、推断了什么,并清楚区分已存储信息与新生成的分析。