
刚刚,Grok 4.7正式发布!马斯克憋了两个月的大招,就这?
本周大模型第一枪,由「跳票大师」马斯克的 SpaceXAI 打响。
Grok 4.7 今天正式发布,2.1 万亿参数,比上一代 Grok 4.6 多 40%。SpaceXAI 官方宣称「 Grok 4.7 价格不变、速度不变,性能全面提升。」
听起来很美,但注意我的用词,「官方宣称」。
Grok 4.7 跳票,从 7 月就开始了。
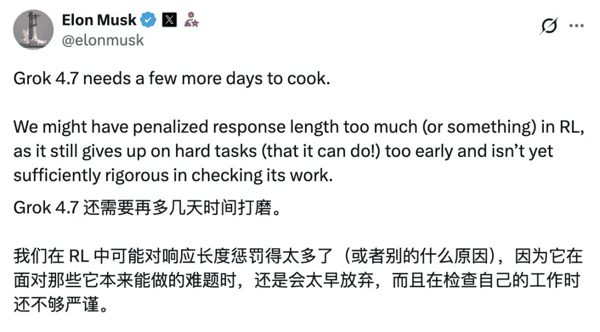
7 月 24 日马斯克放话「 Grok 4.7 4 周内发布」,8 月 12 日改口「3 到 4 周」,9 月 2 日发帖「10 天后上线」,9 月 11 日又来一句「还差点意思,再等几天」。从首次预告到今天正式发布,将近两个月。
而老马口中的「几天」,我们一等就是十天。
按照马斯克的解释,他们在强化学习阶段可能把回复长度惩罚得太狠, Grok 4.7 碰到难题容易提前放弃,自我检查也不够严谨。他还特意强调,这模型明明有能力解决,就是不肯干到底。
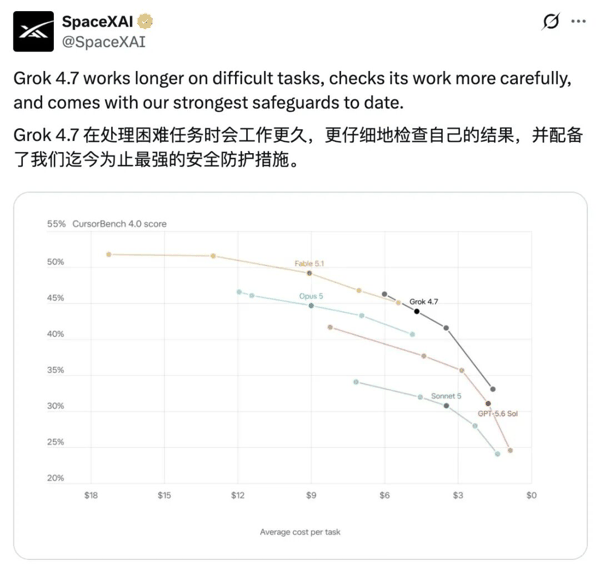
 但如果你翻开 SpaceXAI 官方博文,会看到这样一句话,「 Grok 4.7 在困难任务上坚持得更久,自我检查更加仔细。」
十天前的毛病,反倒成了今天的卖点。牢马,我们能信你吗。
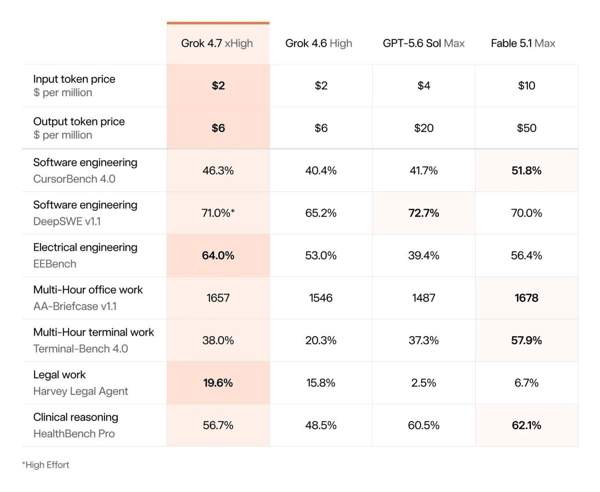
「价格不变」是 SpaceXAI 这次主打的牌。这话理论上没毛病, Grok 4.7 API 定价和 Grok 4.6 一样,每百万输入 token 2 美元、输出 6 美元。
然而第三方独立评测机构 Artificial Analysis 今天公布了一组数据,揭开了 Grok 4.7 背后的隐性成本。
Grok 4.7 在最高推理强度下,每个测试任务平均消耗 81000 输出 token,同样的任务 Grok 4.6 只要 36000, GPT-6 Astra 更少,只要 27000 token。虽然每个 token 的价格没涨,但完成同样的任务, Grok 4.7 要烧掉两倍多的 token,这样算下来 Grok 4.7 每个任务的实际花费比 Grok 4.6 贵了一倍多。
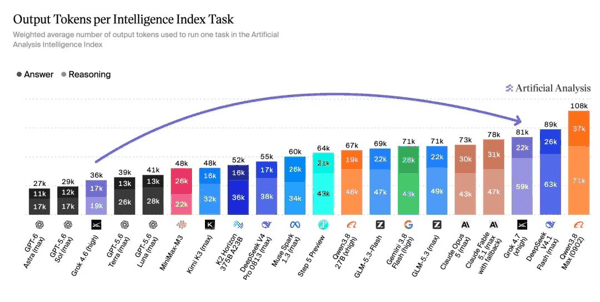 所以,「价格不变」没说错,但也没说全。 Grok 4.7 学会了死磕、不轻易放弃,代价是每个任务消耗的 token 翻了一倍。
乍一看, Grok 4.7 跑分惊艳。
根据 SpaceXAI 官方公布的对比表, Grok 4.7 基本可以和 GPT-5.6 、 Claude Fable 5.1 坐一桌同台竞技了。有些单项基准测试得分甚至超过了这些老大哥。
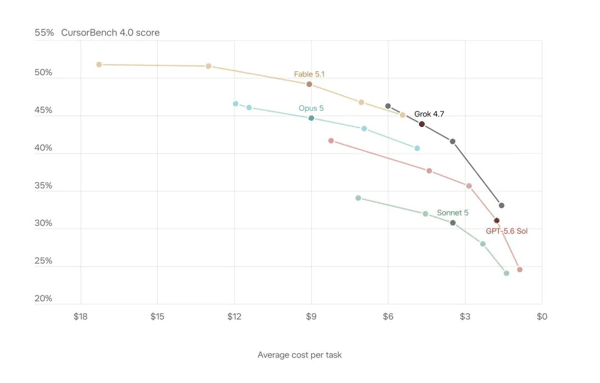
 单看性价比,几乎就要把 Claude Opus 5 斩杀了。
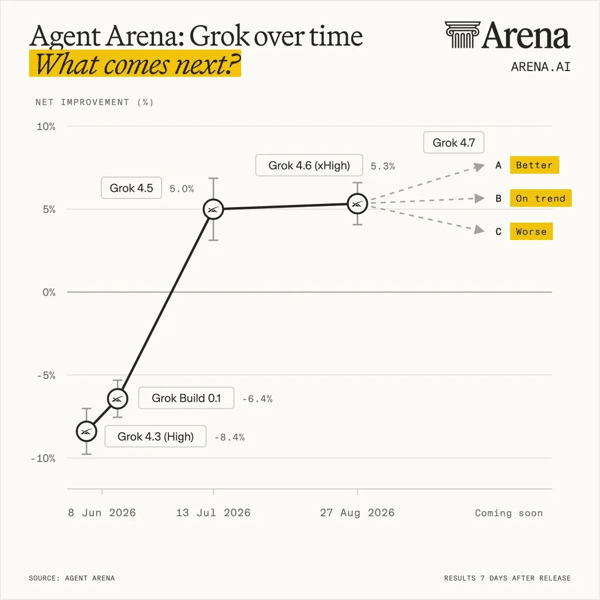
 然而,从第三方的视角来看, Grok 4.6 到 Grok 4.7 的进步,远不如 Grok 4.3 到 Grok 4.5 那么让人眼前一亮。
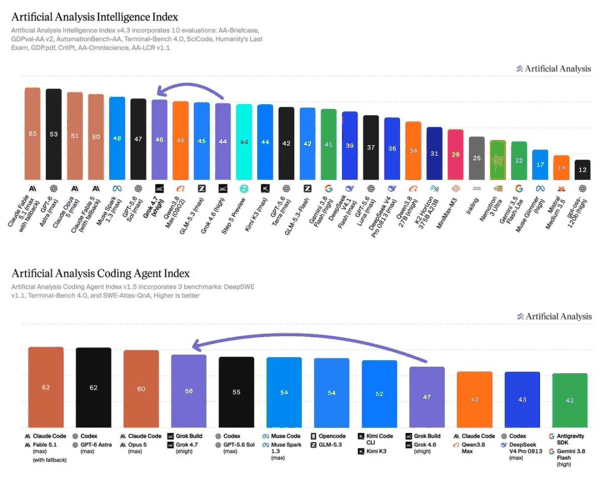
 Artificial Analysis 大模型排行榜, Grok 4.7 综合得分 46 分,相比上一代 Grok 4.6 仅上涨 2 分,排在第 6 名。前面依次是 Claude Fable 5.1 和 GPT-6 Astra (并列第一,53 分)、 Claude Opus 5 (51 分)、 Muse Spark 1.3 (48 分)、 GPT-5.6 Sol (47 分)。
Grok 4.7 和第一梯队还有明显差距。
 Grok 4.7 的进步主要来自知识工作领域,AA-Briefcase(一个模拟律师、分析师等专业人员日常任务的评测)涨了 111 Elo 分。但其他方面, Grok 4.7 和 Grok 4.6 基本持平,个别评测甚至出现了退步。
SpaceXAI 官方自家的编程测试 CursorBench, Grok 4.7 成绩 46.3%, Claude Fable 5.1 51.8%。Artificial Analysis 的编程智能体指数里,Grok Build + Grok 4.7 得分 56,第四名。前三名分别是 Claude Code + Claude Fable 5.1 (62)、Codex + GPT-6 Astra (62)和 Claude Code + Claude Opus 5 (60)。
从 Grok 4 被骂翻车到 Grok 4.5 支棱起来,SpaceXAI 只用了两个版本。但从「支棱起来」到「追赶头部」,两个版本显然不够了。
9 月 14 日, Grok 4.7 还在跳票,马斯克已经在画大饼了。
自信的老马对 4.7 的评价是「大致和 Claude Opus 5 一个水平」,然后 4.8 会有明显提升, 4.9 能到 Claude Fable 级别, Grok 5 也许比所有模型都强。
如果真是这样,老马做梦估计都能笑醒了。